
已完成 AI RAG Next.js Cloudflare
EchoMind:輔大資管的 AI 學習助手
專為輔大資管系同學做的 AI 助手:把 42 門課的修課經驗和系上規定整理成 60 類、667 題的知識庫,用 RAG 先檢索再回答,還能切換四種模型、上傳圖片一起問,讀累了有八款紓壓小遊戲。花了大約兩個月,我負責 AI 核心、後端與前端主體。

專為輔大資管系同學做的 AI 助手:把 42 門課的修課經驗和系上規定整理成 60 類、667 題的知識庫,用 RAG 先檢索再回答,還能切換四種模型、上傳圖片一起問,讀累了有八款紓壓小遊戲。花了大約兩個月,我負責 AI 核心、後端與前端主體。
一分鐘看懂 EchoMind 在做什麼。封面與動畫角色由 AI 生成(Codex),旁白是 AI 語音(Gemini TTS),動畫裡的回答是示範。
大二下的「系統分析與設計」要做一個完整的系統。我們想解決一個自己每學期都會遇到的問題:選課和準備考試時,最有用的資訊都在學長姐的腦袋裡。
微積分期中考什麼題型?這門課作業多不多、會不會點名?畢業英文門檻要多少分?這些問題去問 ChatGPT,它只能給很一般的答案,因為它不認識我們系上的課。
所以 EchoMind 的想法很直接:把學長姐的經驗和系上的規定,整理成一個自己的知識庫;同學提問時,先從知識庫找出最相關的內容,再交給模型回答。這也是我第一次從頭到尾做出一個完整的 LLM 加 RAG 應用。
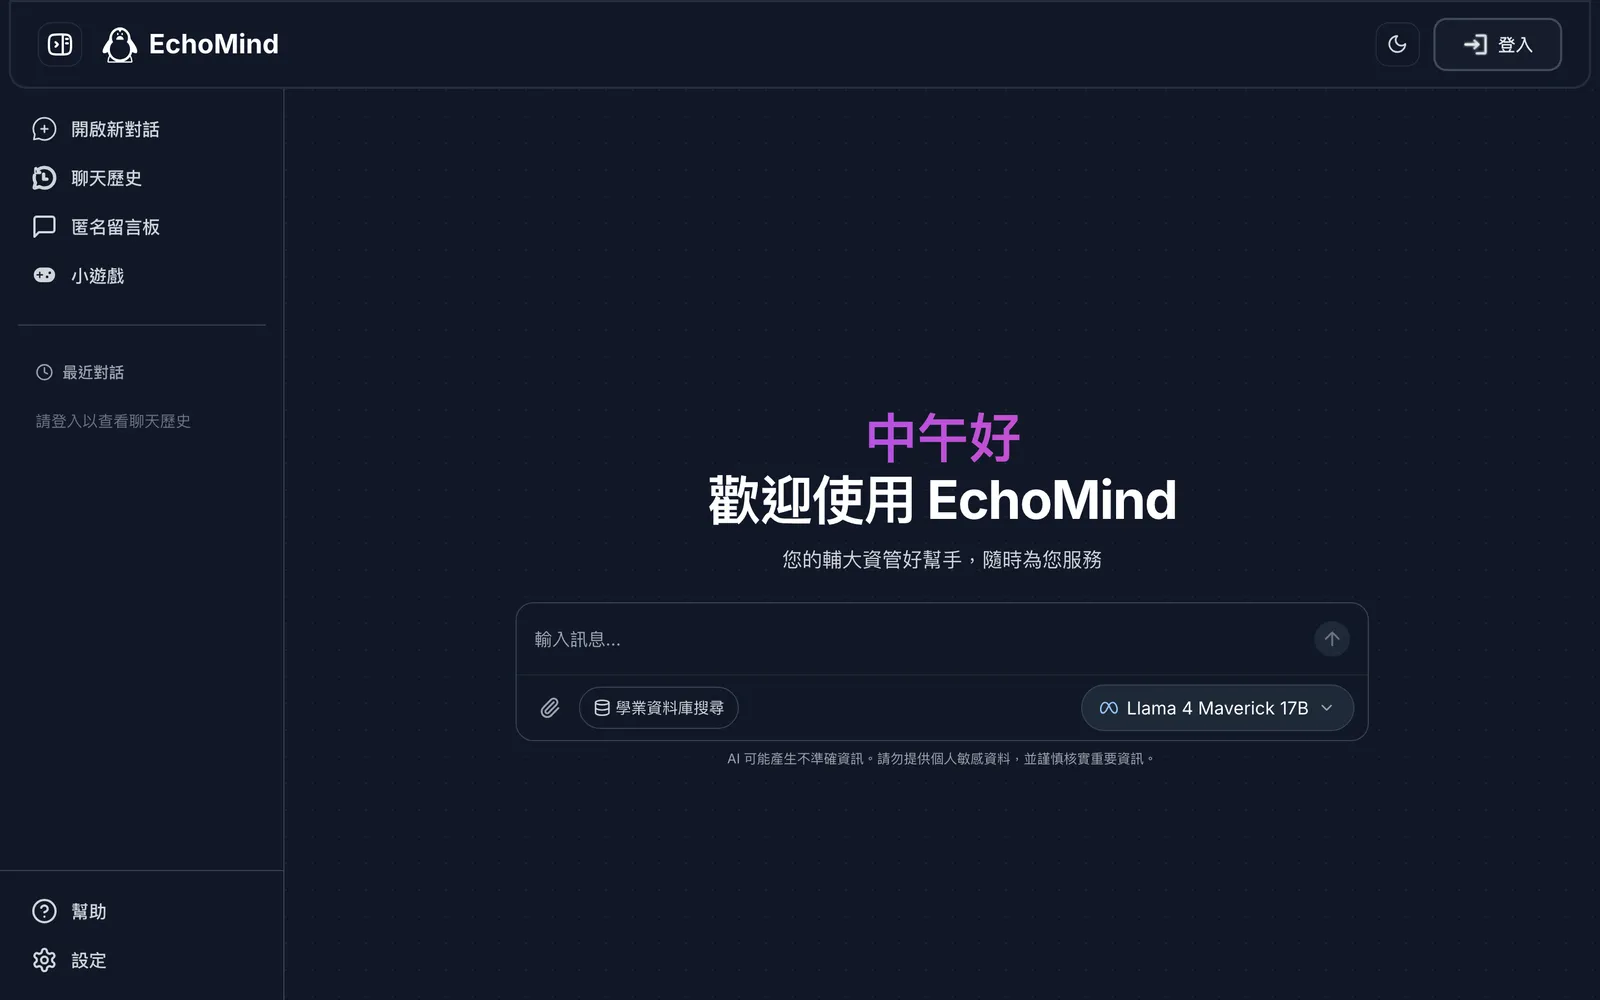
首頁會依時段顯示問候語。輸入框下方可以切換「學業資料庫搜尋」、選模型,或附上圖片。
一般聊天模式下,後端會先從知識庫找出最相關的 3 題,放進提示詞,再請模型回答。
老實說,這個模式現在沒辦法示範:當初用的四個 Groq 模型,有的已經被 Groq 下架,有的帳號已經沒有權限,線上版的一般聊天目前都會回錯誤。要換成現在還提供的模型才會恢復。
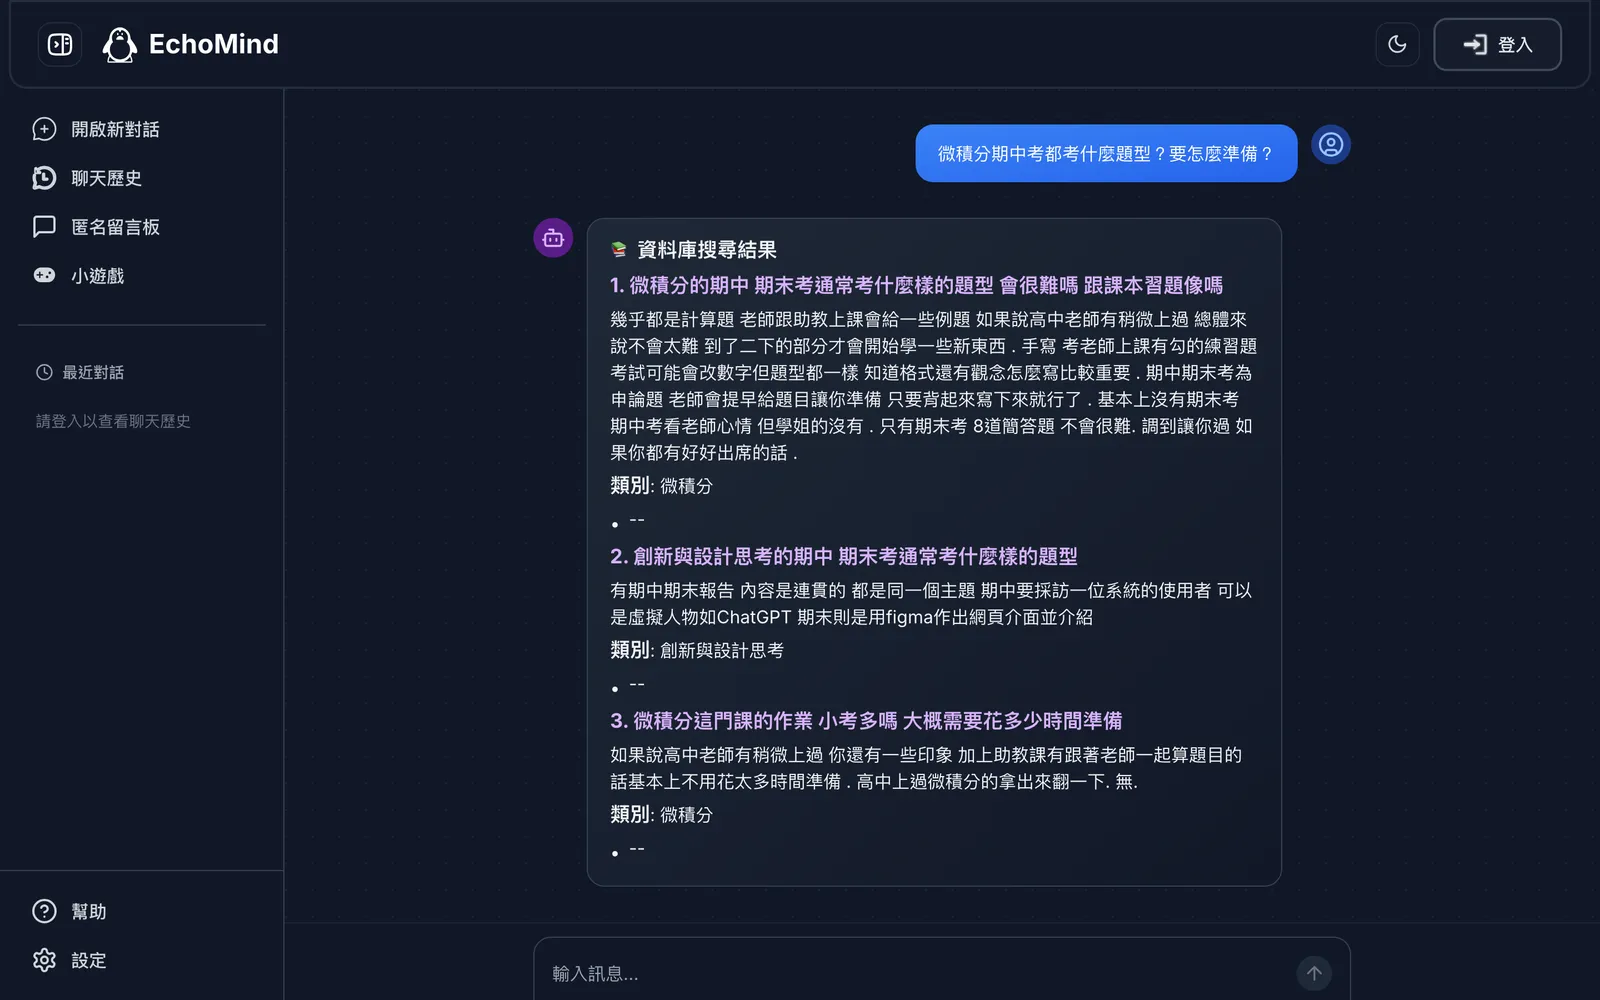
打開「學業資料庫搜尋」:不經過模型,直接列出最相關的幾筆原始問答,適合想看學長姐原話的時候。這個模式不需要語言模型,所以現在仍然可以用。
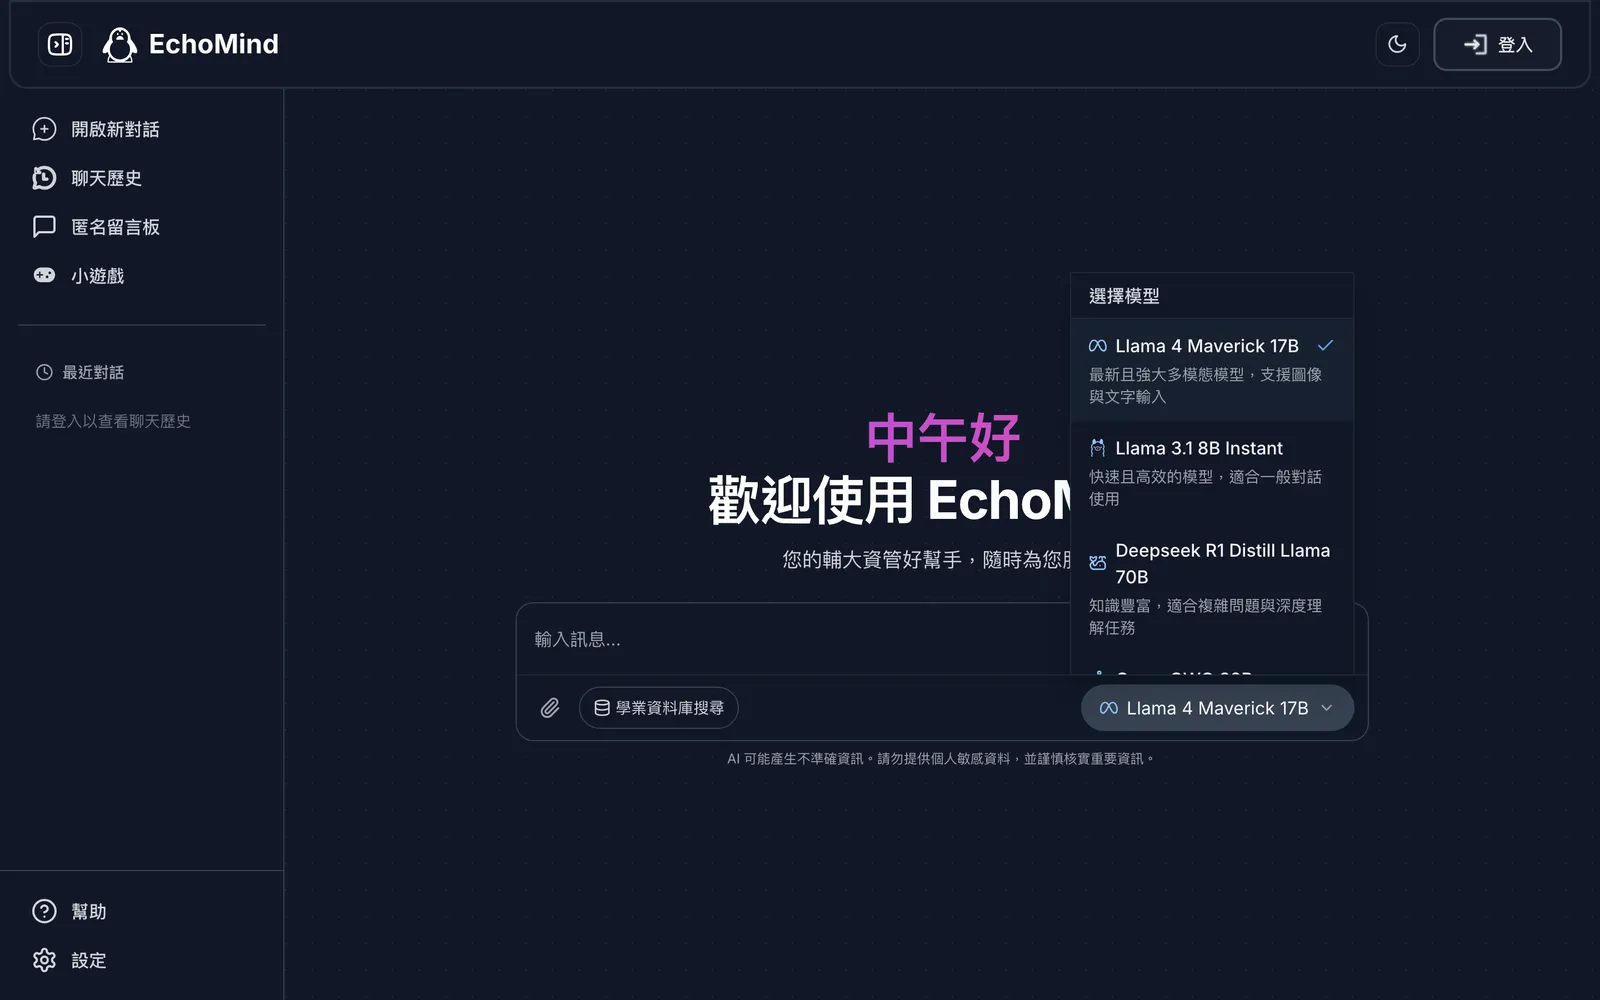
四種模型都走 Groq。選 Llama 4 Maverick 時可以上傳圖片一起問,例如拍下題目請它解釋。
讀書讀到一半需要休息,所以我們做了八款小遊戲,全部都能直接在網站上玩:
| 遊戲 | 玩法 |
|---|---|
| ⌨️ 打字 | 限時打單字,計算每分鐘字數和正確率,可以選單字表和主題 |
| 🧩 拼圖 | 拖曳交換拼圖塊,有 4×4 到 6×6 三種難度,計時也計步數 |
| 🐍 貪吃蛇 | 可以穿牆,速度可調,空白鍵暫停 |
| 🫧 呼吸 | 按住吸氣、放開吐氣,搭配冥想音樂 |
| 🪵 敲木魚 | 每敲一下浮出「歐趴 +1」,考前求心安 |
| 🔨 打地鼠 | 兩輪各 15 秒,第二輪更快;金色地鼠加分,炸彈地鼠扣 3 分 |
| ⚫ 五子棋 | 和電腦對戰,分三種難度,電腦會判斷「活三」 |
| 🔢 賓果 | 經典、快速、挑戰三種模式,連成一線就贏 |
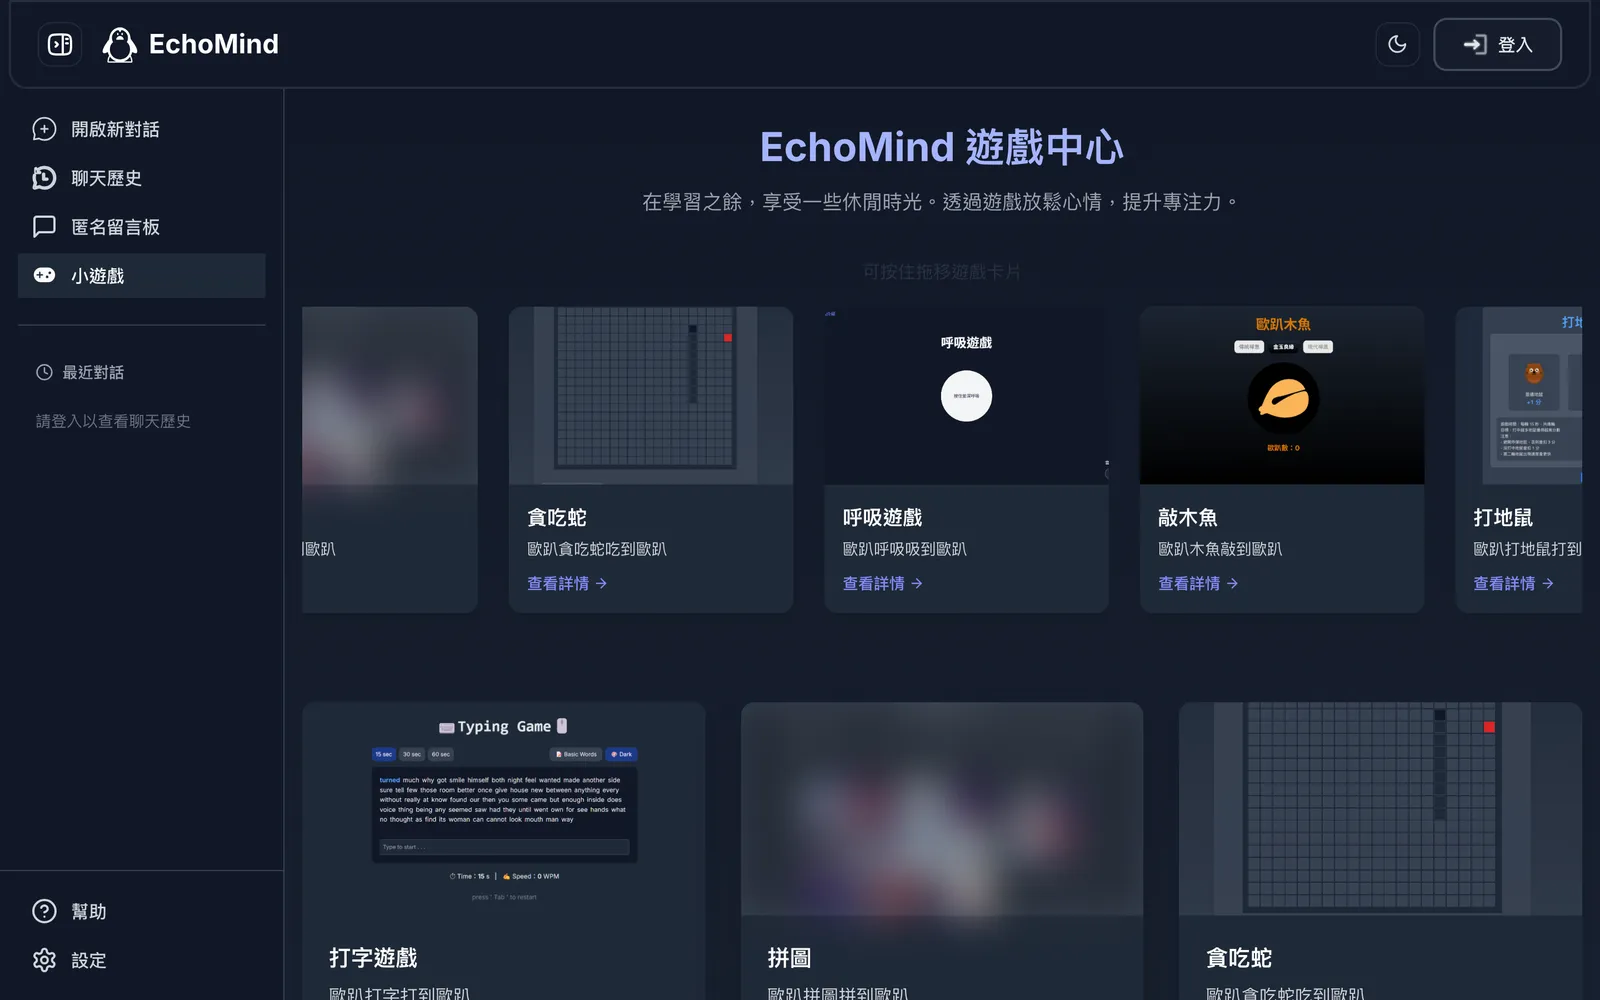
遊戲卡片牆,深淺色主題各有一套封面。拼圖卡片上是動畫角色圖,截圖時做了模糊處理。
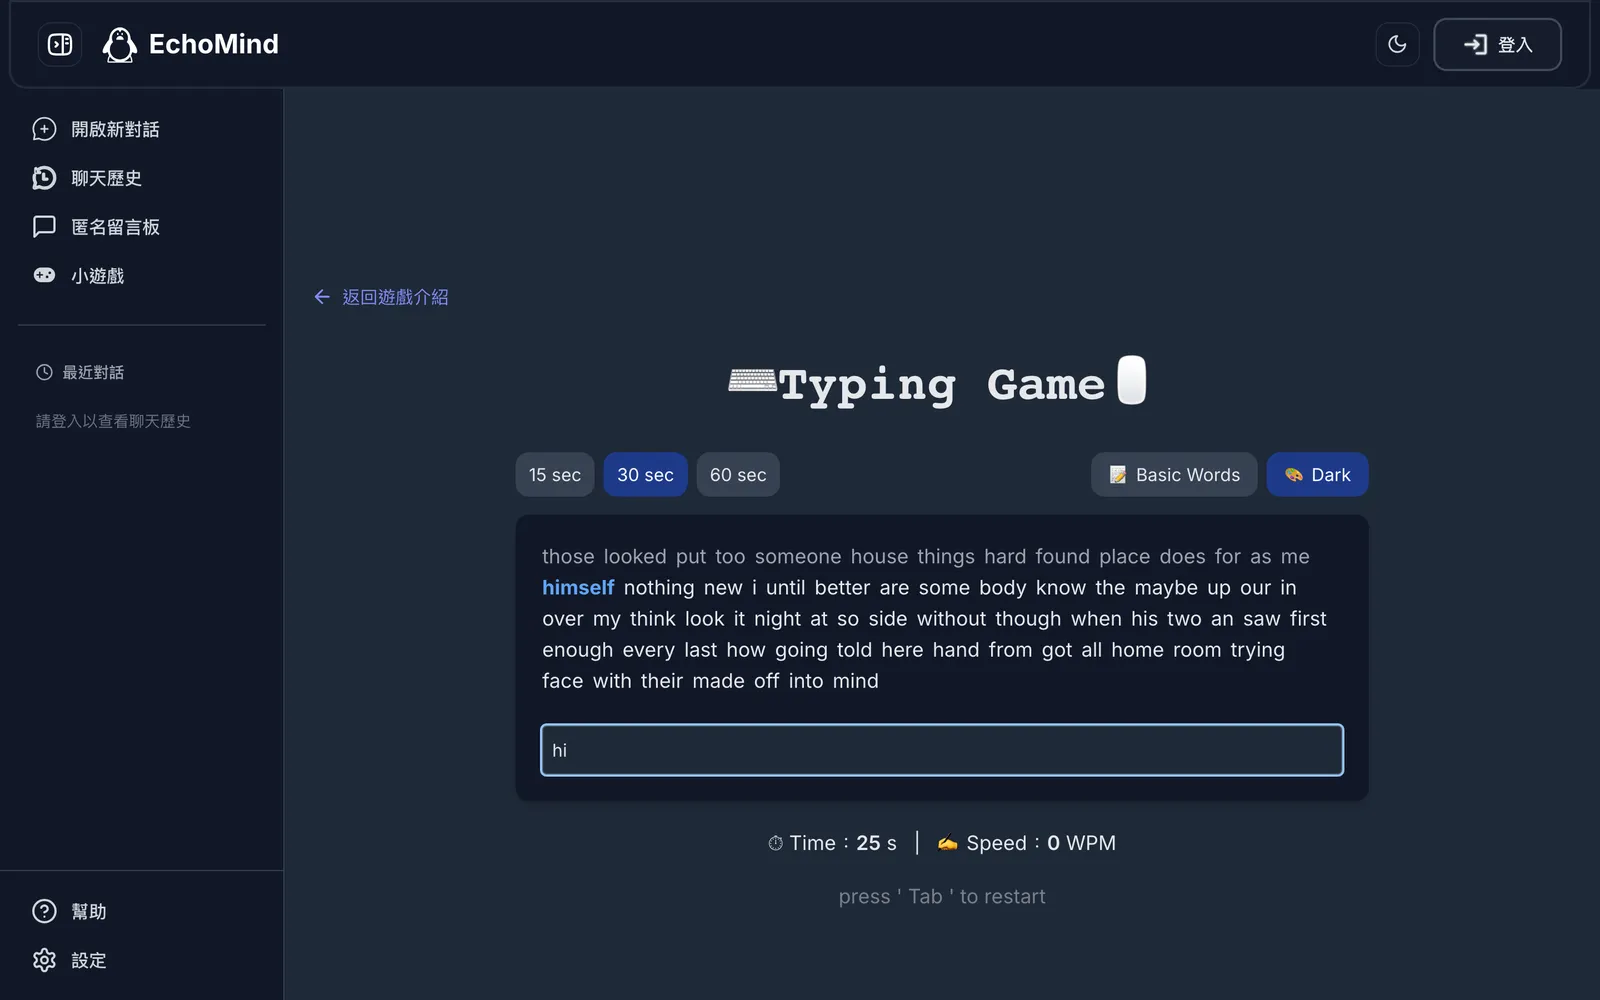
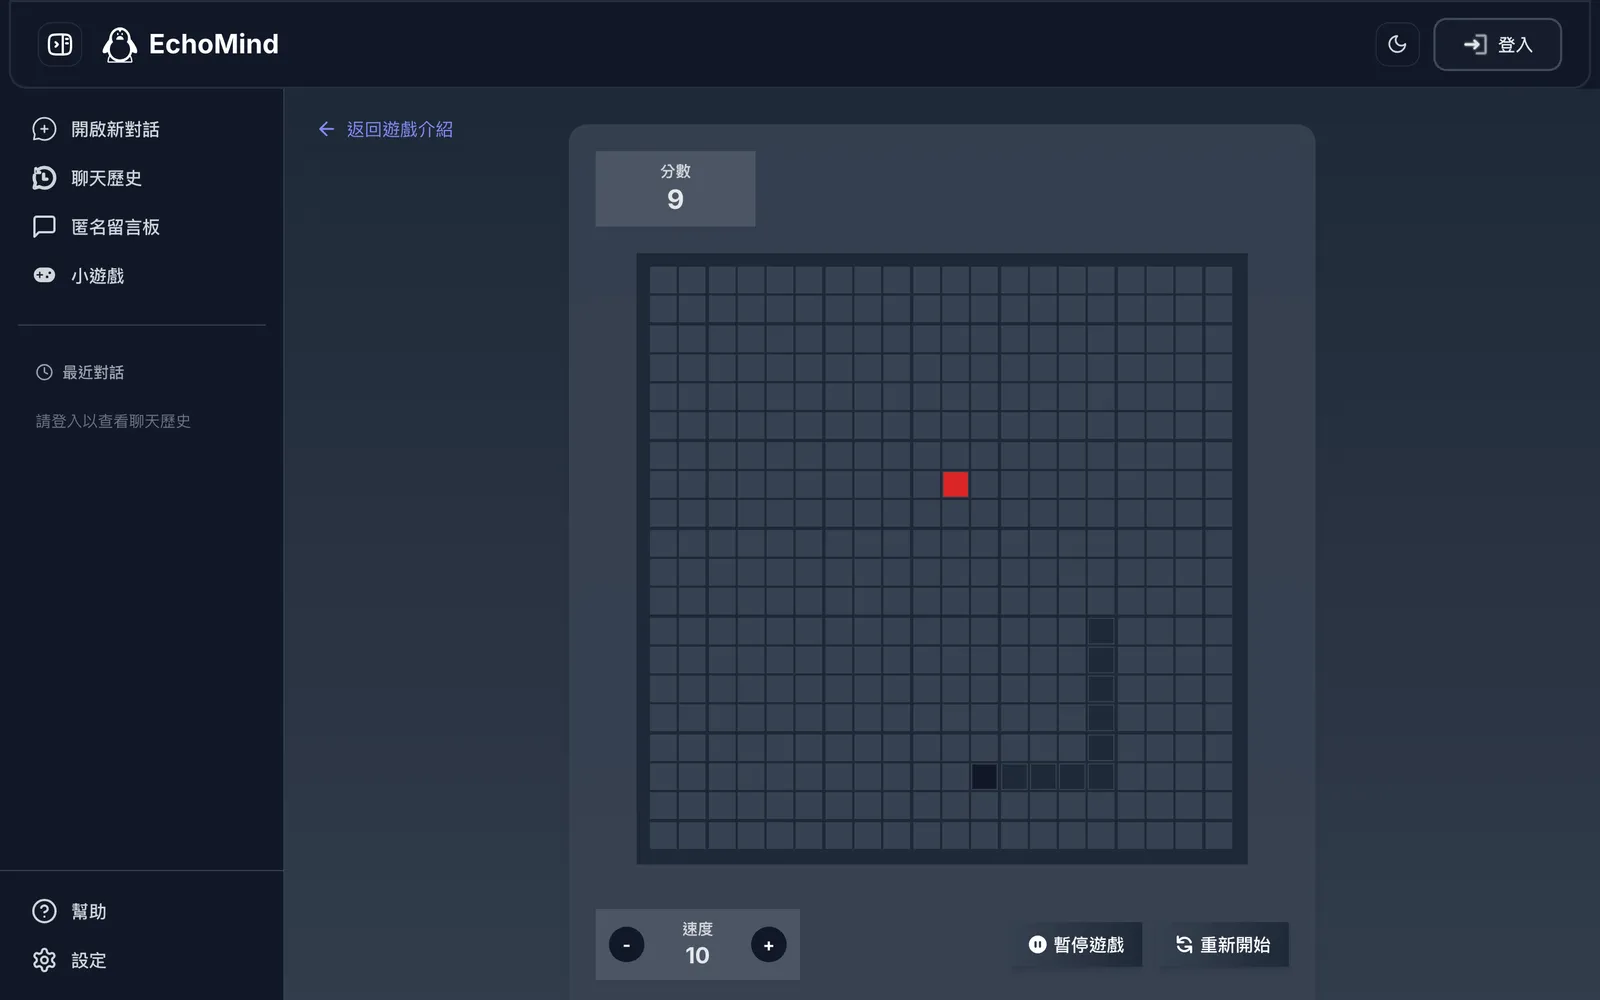
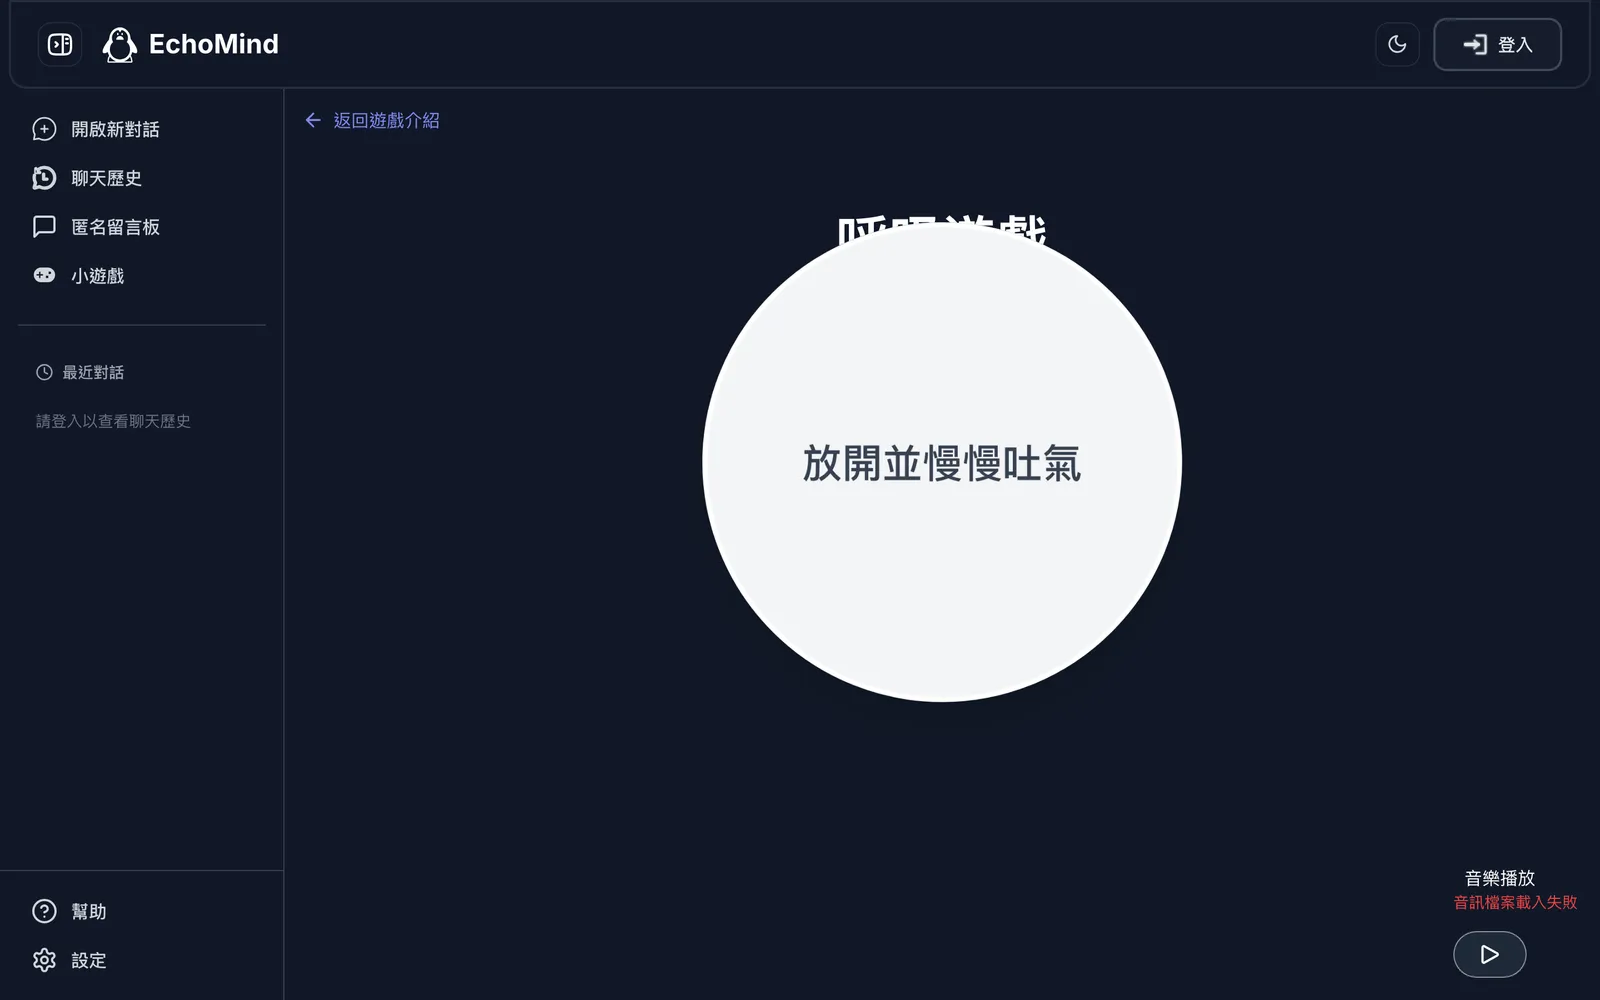
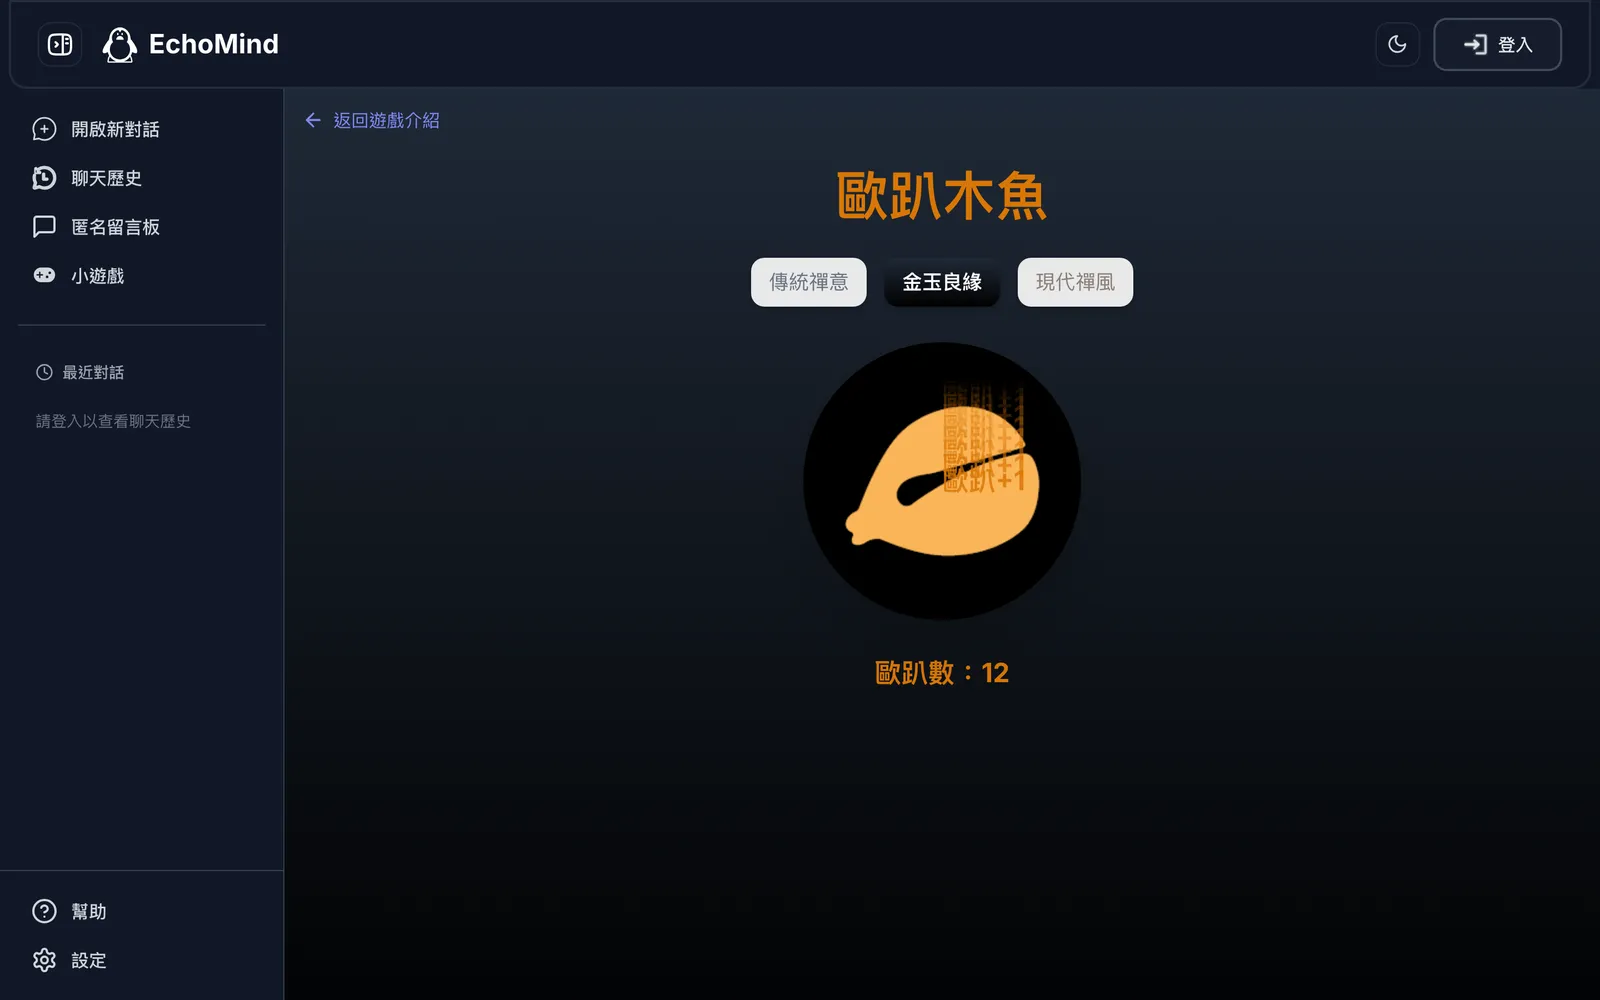
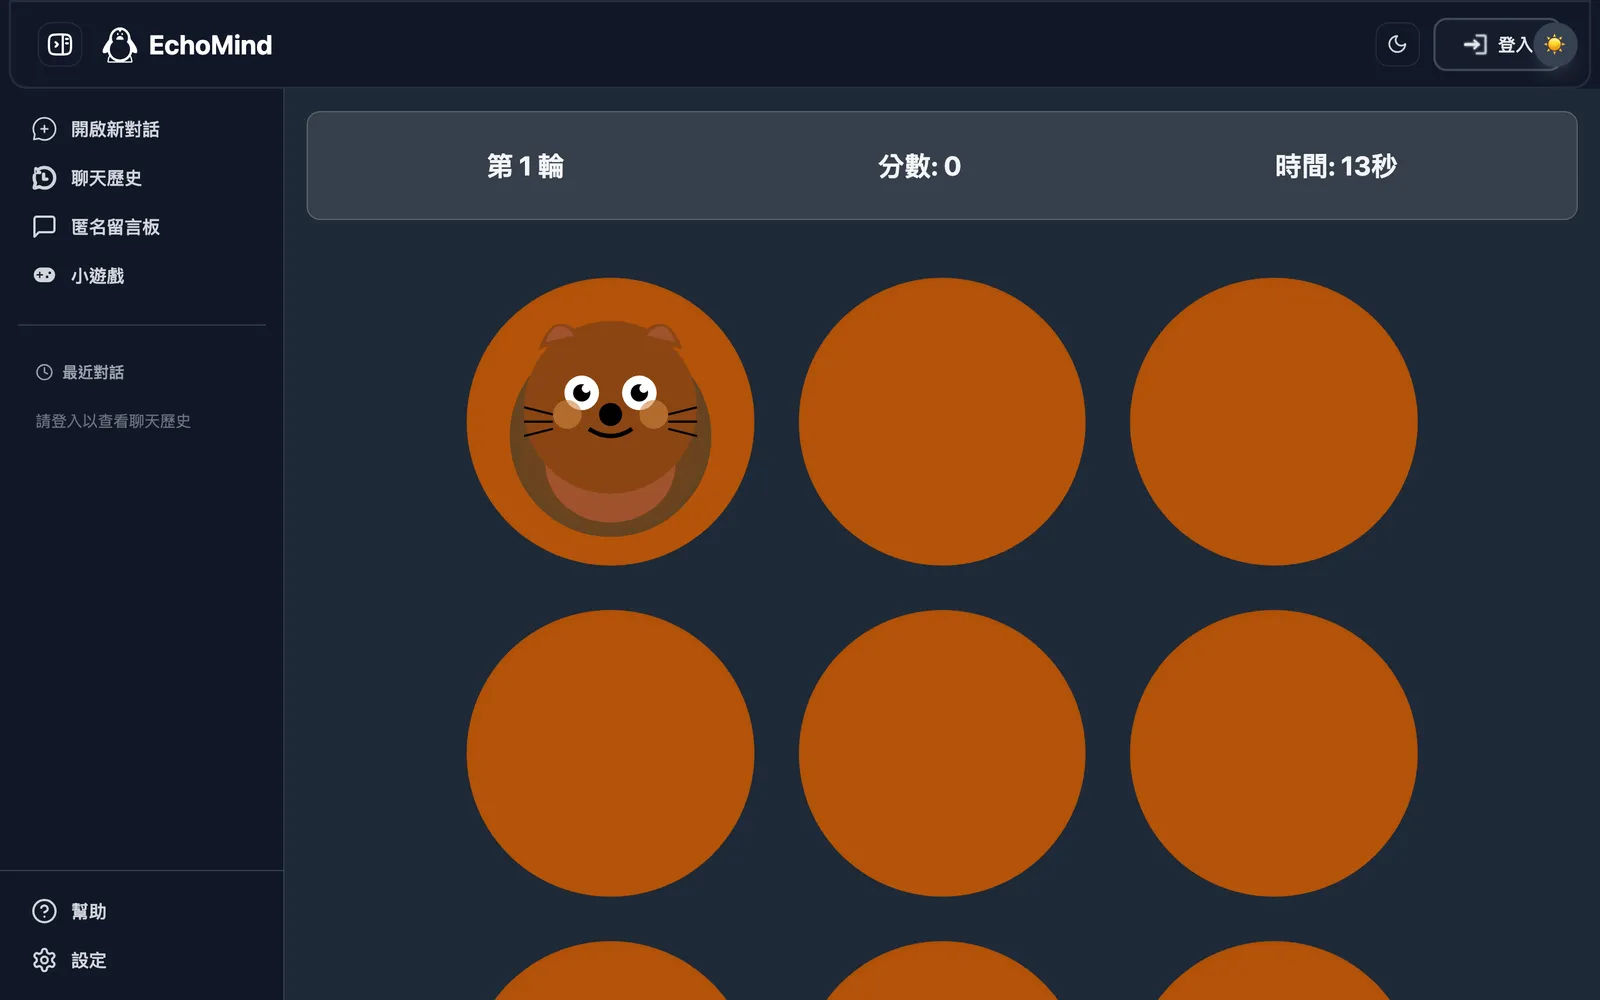
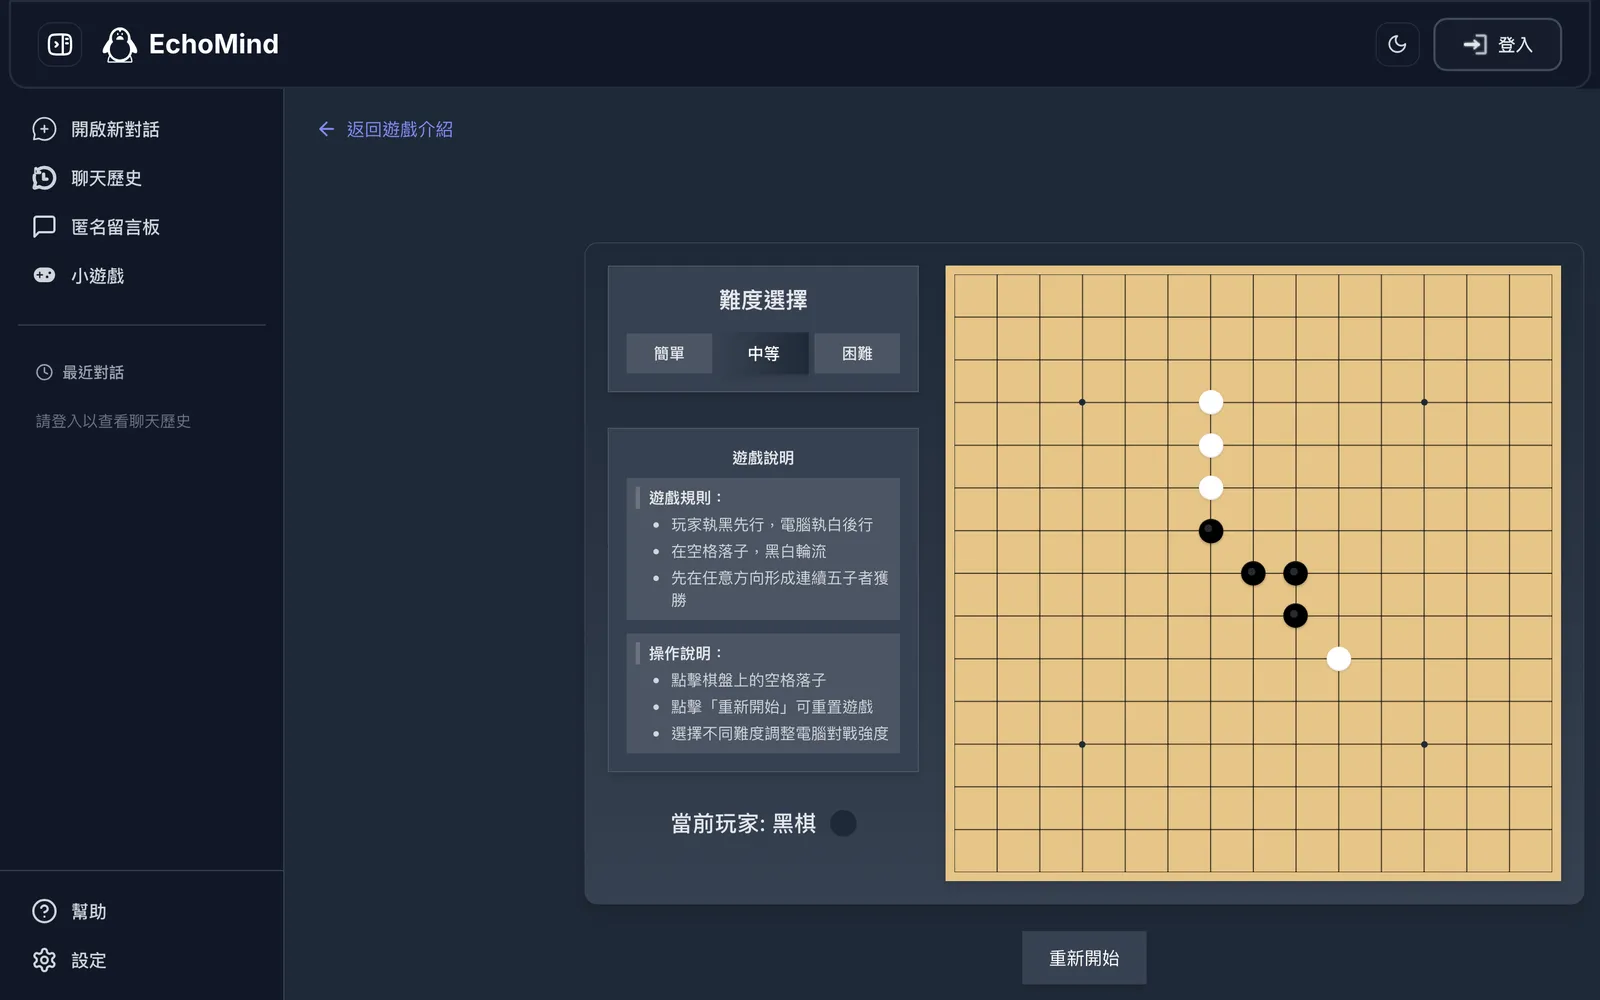
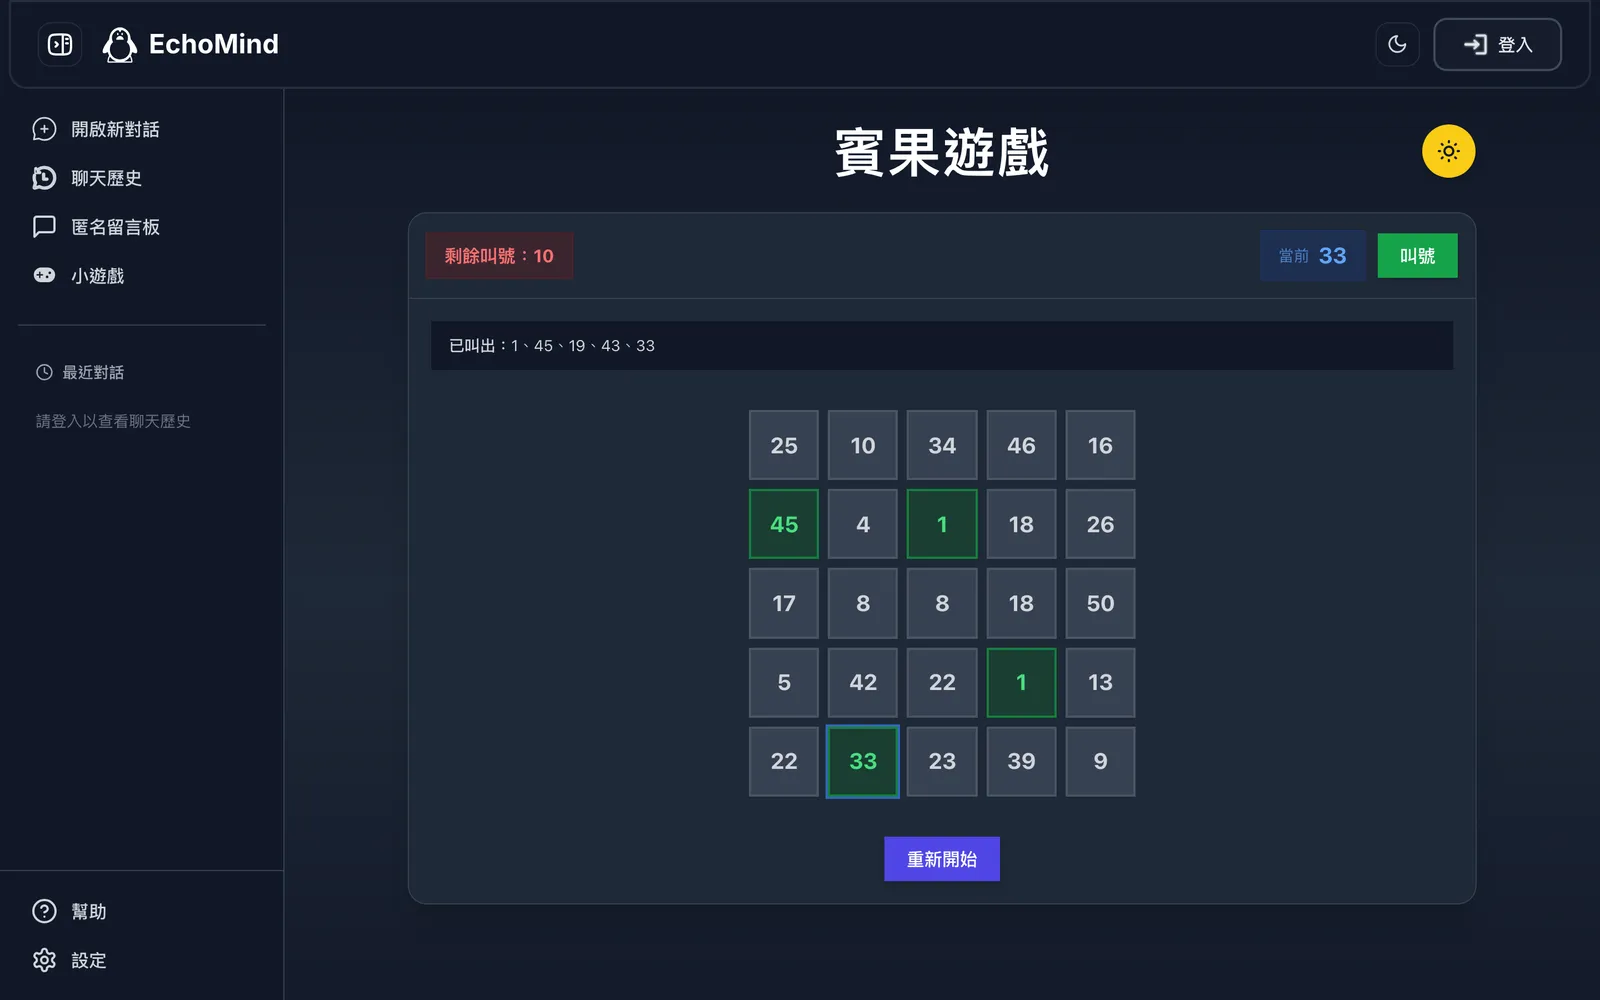
由左到右:打字、貪吃蛇、呼吸、敲木魚、打地鼠、五子棋、賓果。拼圖用的是動畫角色圖,這裡不放截圖。
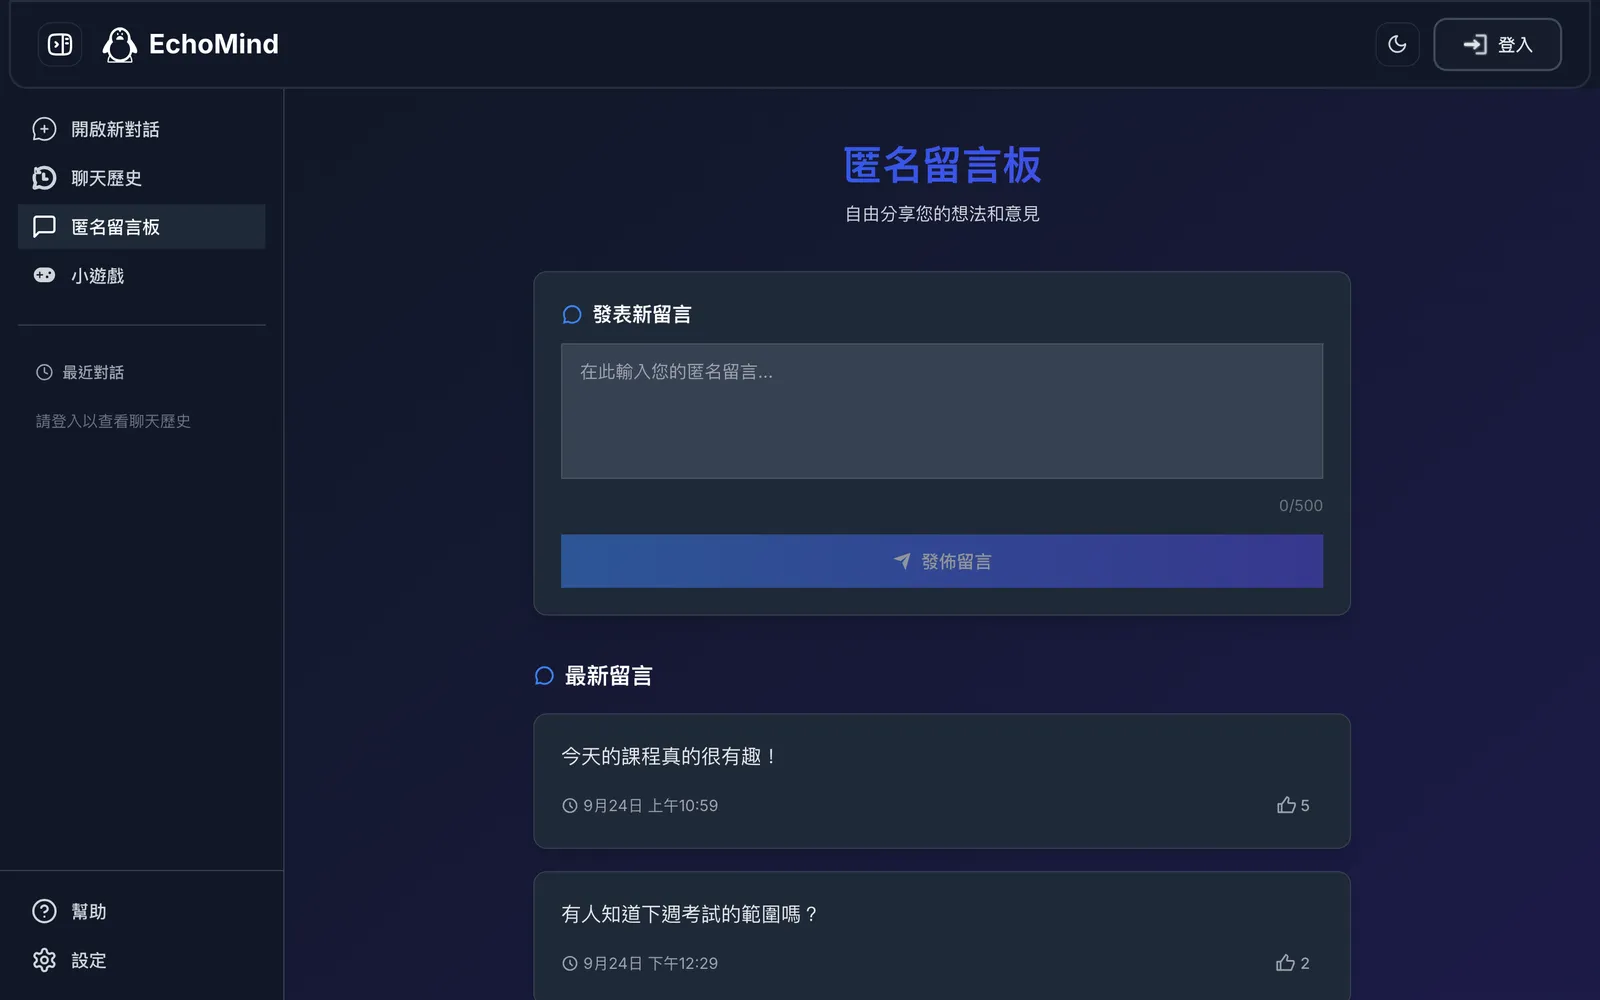
匿名留言板。老實說,這一頁只做到介面雛形:留言還沒有接後端,重新整理就會消失。
另外還有登入後才看得到的聊天歷史、個人資料頁(可以上傳頭像),以及附教學圖的使用說明頁。
RAG 答得好不好,取決於知識庫的品質。這個知識庫是整個專案最花時間的部分,前後擴充了好幾次,4 月從 400 題擴充到 667 題。
課程經驗:42 門課。 從微積分、會計學、企業概論、程式設計、資料結構、資料庫、統計學、經濟學、系統分析與設計、網路、Web 程式設計、雲端、電子商務、行銷、生產管理,到通識、語言、體育和軍訓。每門課大約 7 題,問的都是修課前最想知道的事:考試題型、作業和小考多不多、會不會點名、要花多少時間準備、老師的上課風格。
系務與規定。
| 類別 | 題數 | 類別 | 題數 |
|---|---|---|---|
| 畢業門檻 | 81 | 選課、加退選、停修 | 各 20 |
| 英文門檻 | 45 | 系上資源與設備 | 20 |
| 證照與進修 | 40 | 系上組織與活動 | 20 |
| 師資資訊 | 35 | 學習資源 | 13 |
| 課程規劃與建議 | 28 | 寒暑假時間 | 10 |
| 專業發展 | 22 | 程式語言機測 | 9 |
| 請假 | 20 | 職涯規劃 | 7 |
| 轉系、雙主修、輔系 | 5 | 專題與競賽 | 5 |
每一題都標上重要程度、關鍵字、相關資源(課程大綱、考古題、助教、iLearn 等)和解答。整理好的 JSON 再用 Python 腳本分批(每批 90 筆)轉成向量,重建 Pinecone 索引。
embed-multilingual-v3.0 轉成 1024 維向量,再到 Pinecone 找最相關的問答。聊天模式取前 3 筆、相似度門檻 0.3;知識庫搜尋模式取前 5 筆直接顯示。EchoMind 其實做了三版:
| 時間 | 版本 | 做了什麼 |
|---|---|---|
| 3 月上旬 | 1.0 | React + Vite,定位是常見問題查詢加上「關懷對話」 |
| 3 月中旬 | 2.0 | 改用 Next.js,重新設計介面 |
| 3 月中旬到 5 月中旬 | 3.0 | 延續 2.0 的程式,加入 RAG、模型切換、圖片問答、小遊戲、登入與聊天紀錄;知識庫在 4 月大幅擴充 |
3.0 的 main 分支共 191 個 commit:3 月 79 個、4 月 89 個、5 月 23 個,最忙的是 4 月。
importance 欄位的資料刪掉,結果符合的問答全被濾光。我改成缺欄位時給預設值 1.0,並在每一步加上日誌。input_type 要分開用:建索引時用 search_document,搜尋時用 search_query,兩者不能混用。Cohere 新舊版 API 的回傳格式也不同,程式要兩種都能處理。example.json,合併時衝突集中在這個檔案,每次都要逐段比對。事隔一年回頭看,我會先改這幾件事:
EchoMind 的完整原始碼:Next.js 前端、Cloudflare Workers 後端,以及知識庫上傳腳本。
可以直接開啟使用。