


靜態檢查八項全部通過。我把機器狗放在客廳中間,下了第一個指令:往前走 0.3 公尺。
它走歪了,直接撞上旁邊的家具。
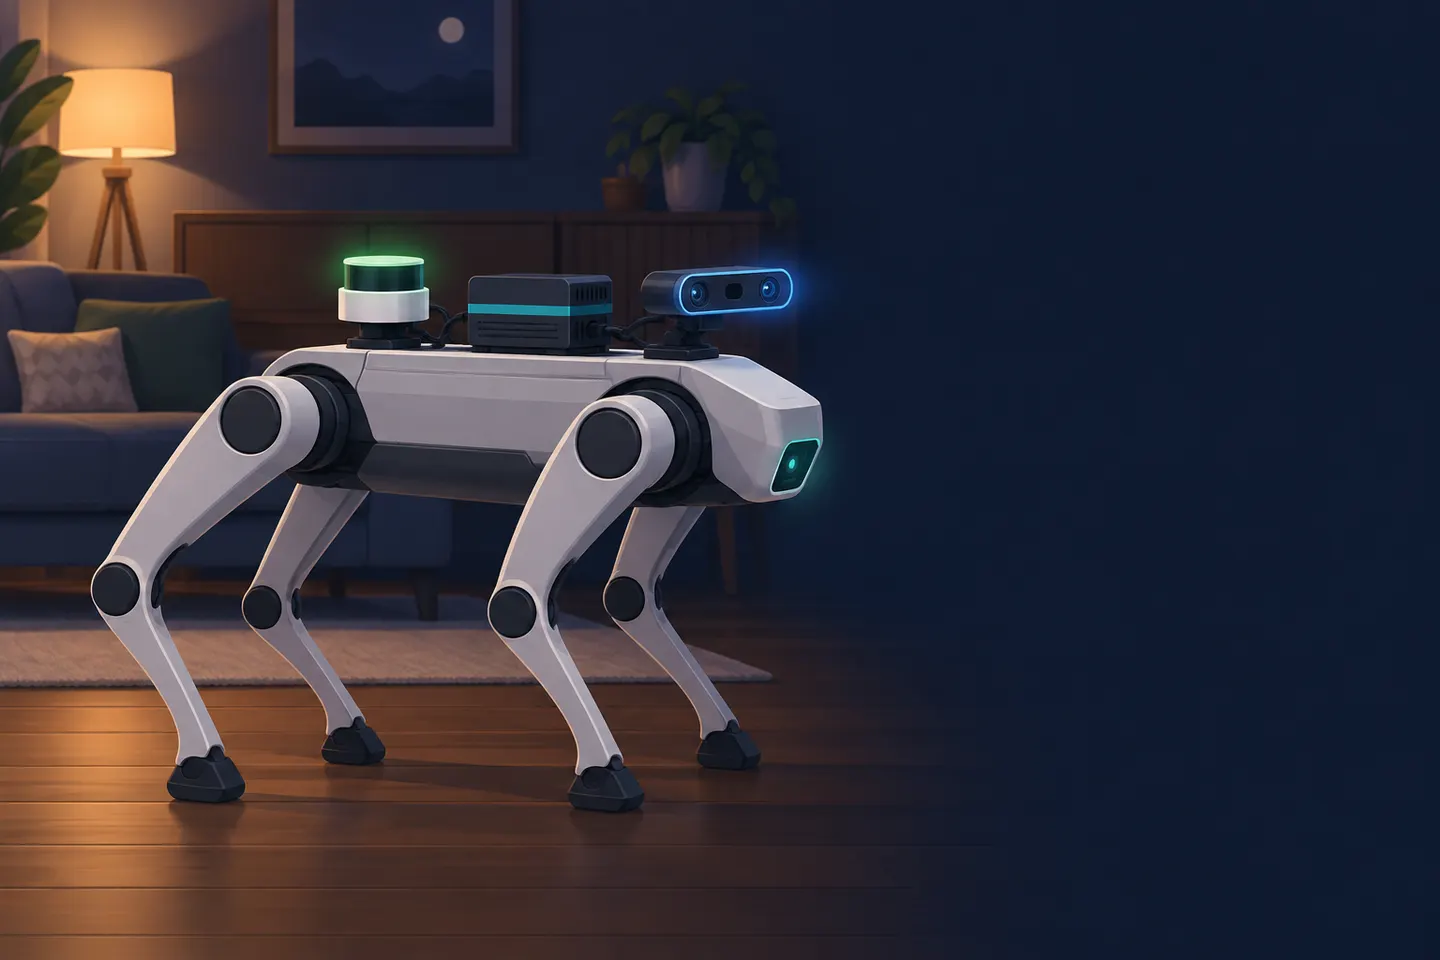
這是 PawAI 做到第八個月時的一幕。PawAI 是我以 Unitree Go2 為載體做的互動機器狗:背上一台 NVIDIA Jetson,前面一顆 RealSense 深度相機,加上雷射雷達、喇叭和一整套人臉、語音、手勢、姿勢辨識。它最後在專題發表上拿到系上第一名,也到台大做過現場展示,能聽懂你的話、跟你打招呼、做出動作。
但有一件事,它從頭到尾都沒有做穩:可靠地移動。
這篇不是成果展示,而是一份用數據說話的復盤。我把這八個月遇到的困難,依硬體、感測器、導航、語音互動和測試整理出來:症狀是什麼、量到了什麼、後來查到的真正原因是什麼、有沒有解決。篇幅很長,可以直接從目錄跳到想看的章節。
先用一分多鐘看完這八個月。插圖由 AI 生成(Codex),旁白是 AI 語音(Gemini TTS)。
實體測試,跟網頁開發完全不同
先說測試,因為它影響了後面幾乎所有事情。
我原本是寫網頁的。網頁出錯,改一行、存檔、瀏覽器重新整理,兩秒鐘就知道結果;測壞了也不會怎樣,再跑一次就好。機器狗完全不是這樣:
| 網頁開發 | 機器狗實測 | |
|---|---|---|
| 測一次要多久 | 存檔、重新整理,幾秒 | 開機、連線、確認電量、把狗搬回起點,每次好幾分鐘 |
| 測試環境 | 每次都一樣 | 光線、地面、家具位置、電量、溫度每次都不同 |
| 測壞了 | 重新整理 | 狗可能撞牆、摔倒,要先確認有沒有受損 |
| 可以同時測幾個 | 開很多分頁 | 只有一隻狗、一個場地 |
| 誰來測 | 自動化測試 | 我一個人:一手拿急停、一邊看螢幕、一邊站在狗旁邊 |
實際上遇到的,是這些很瑣碎、卻每天都在發生的事:
- 每次都要把狗歸位:地上用膠帶標出起點,每次測試前把 12 公斤的狗搬回同一個位置、同一個方向,障礙物也要擺回同一個地方,再用捲尺從機鼻量距離。不這樣做,兩次測試的結果就沒辦法比較。
- 每次都要先看電量:電量低於一半就不測,因為電壓不夠時會斷電,測到一半的結果全部作廢。有一次十輪防撞測試,才做到第一輪狗就沒電了。
- 空間太小,雷達的誤差被放大:狗前方大約 1.1 公尺就是牆或家具,安全機制判斷「太近」就不讓狗走,只好另外調一組窄場參數。雷達的一點點角度誤差,在這麼小的空間裡就是撞與不撞的差別。
- 一個人測所有功能:人臉、語音、手勢、姿勢、移動,都是我自己站在鏡頭前、自己喊指令、自己比手勢。沒辦法測「陌生人」和「兩個人同時出現」,這幾項只能跳過。
- 出問題就要全部重測:有一次改了參數卻沒有重新編譯,我對著舊程式白測了三個小時;後來同樣的錯又犯了一次,又多花五個小時。每一次都要從頭再跑一輪。
場地有多小?下面是依照片和實際量測重建的測試空間:
測試空間的 3D 模型,家具為示意。淡綠色是整個可以走的 L 形地面;深綠色是主要測試區,大約 2.5 × 1.5 公尺;淡藍色的圈是雷達半徑 1.2 公尺的範圍。靠工作桌那端寬約 2.5 公尺,往門口被桌子、列印機和推車擠成約 0.9 公尺的走道,全長大約 6 公尺。
在這種空間裡,導航演算法幾乎沒有繞路的餘地。這也是為什麼後面很多問題,都是在「0.3 公尺」「20 公分」這種尺度上發生的。
硬體:讓一隻狗背得動一台電腦
原廠的 Go2 很會走、會跑、會自己站起來,但它不會認人、不會聽你說話,也不會自己決定要做什麼。PawAI 要做的,就是在它身上加一顆「腦」和一組「感官」。聽起來只是把東西裝上去,實際做起來,幾乎每個零件都有自己的問題。
最後的樣子

從狗頭往狗尾,PawAI 背上依序是:
- 深度相機(Intel RealSense D435):裝在額頭,負責看人、看物體,也看腳前的障礙物。
- 2D 雷射雷達(RPLIDAR A2):裝在 3D 列印的支架上,負責掃描周圍、建地圖。
- USB 喇叭:讓狗說話。
- 運算盒(NVIDIA Jetson Orin Nano Super 8GB):所有辨識、決策和控制都在這裡跑。
- 降壓器:把 Go2 電池的電壓轉成 Jetson 能用的電壓,裝在最後面。
Jetson 和 Go2 之間用網路線直接連線。語音辨識和語言模型因為太吃資源,放在遠端的 GPU 上跑。
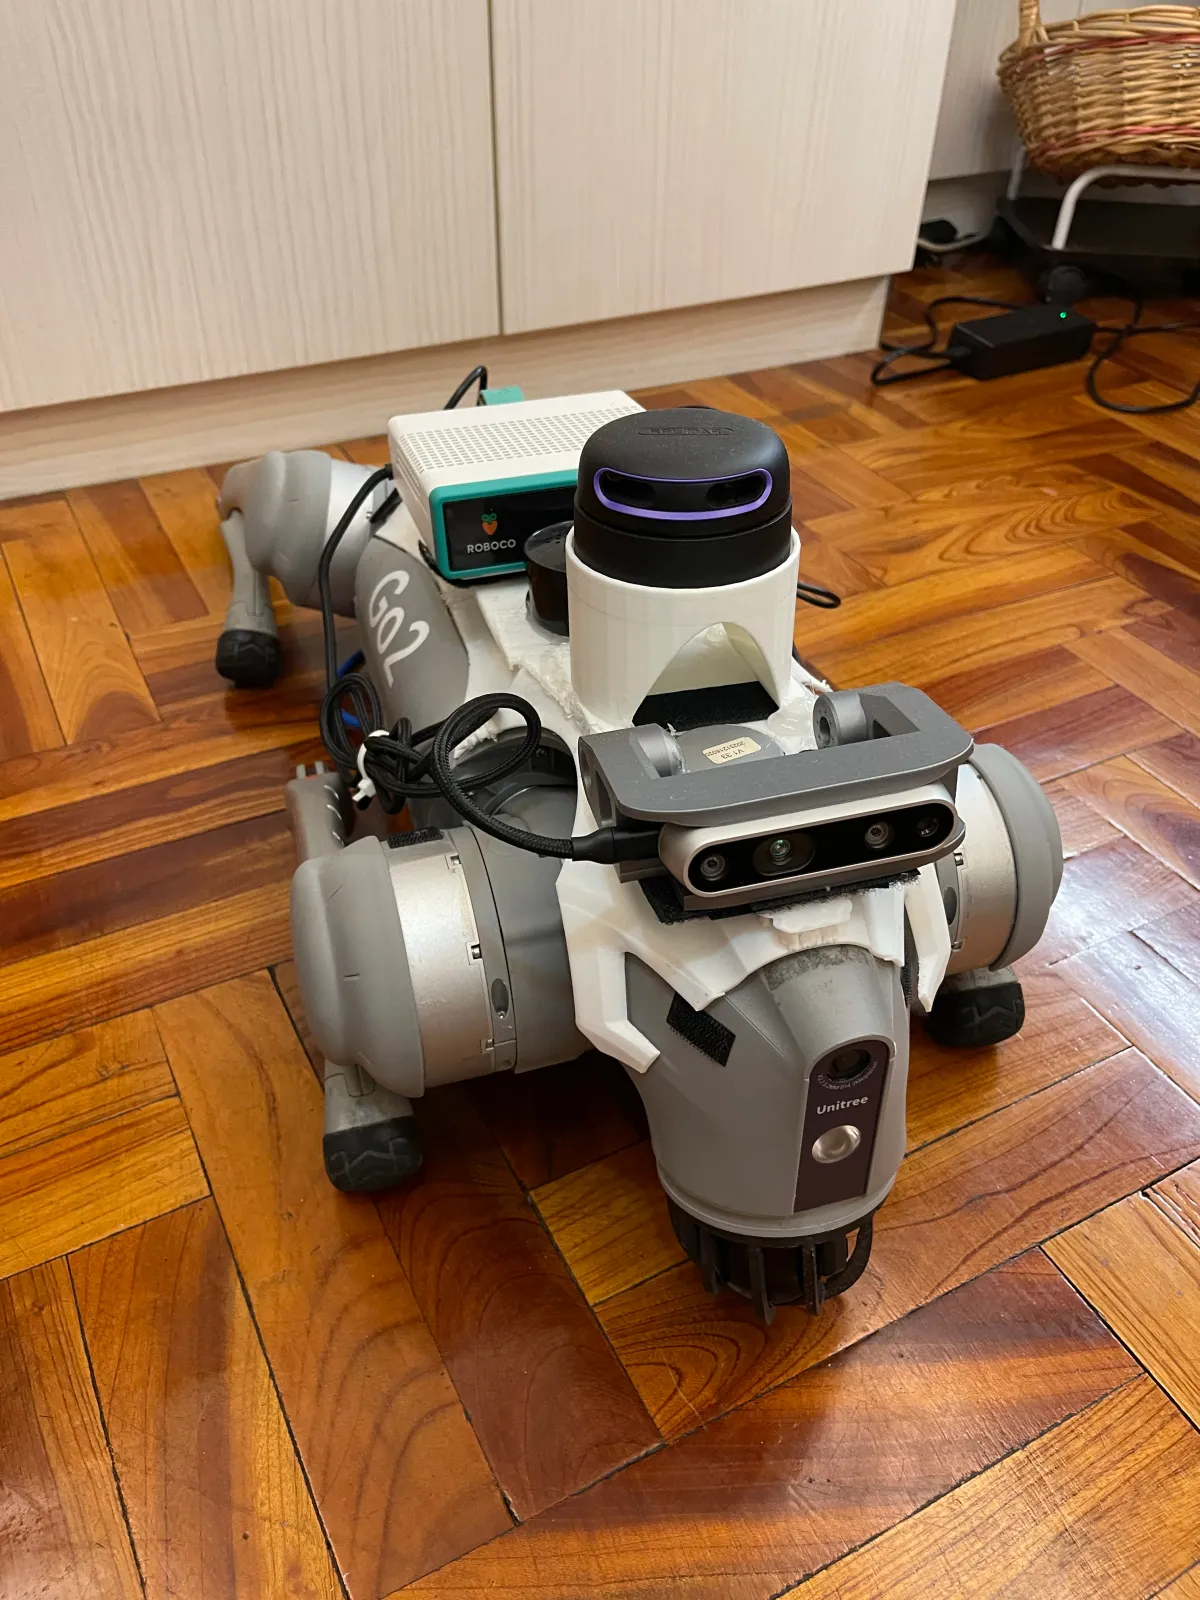
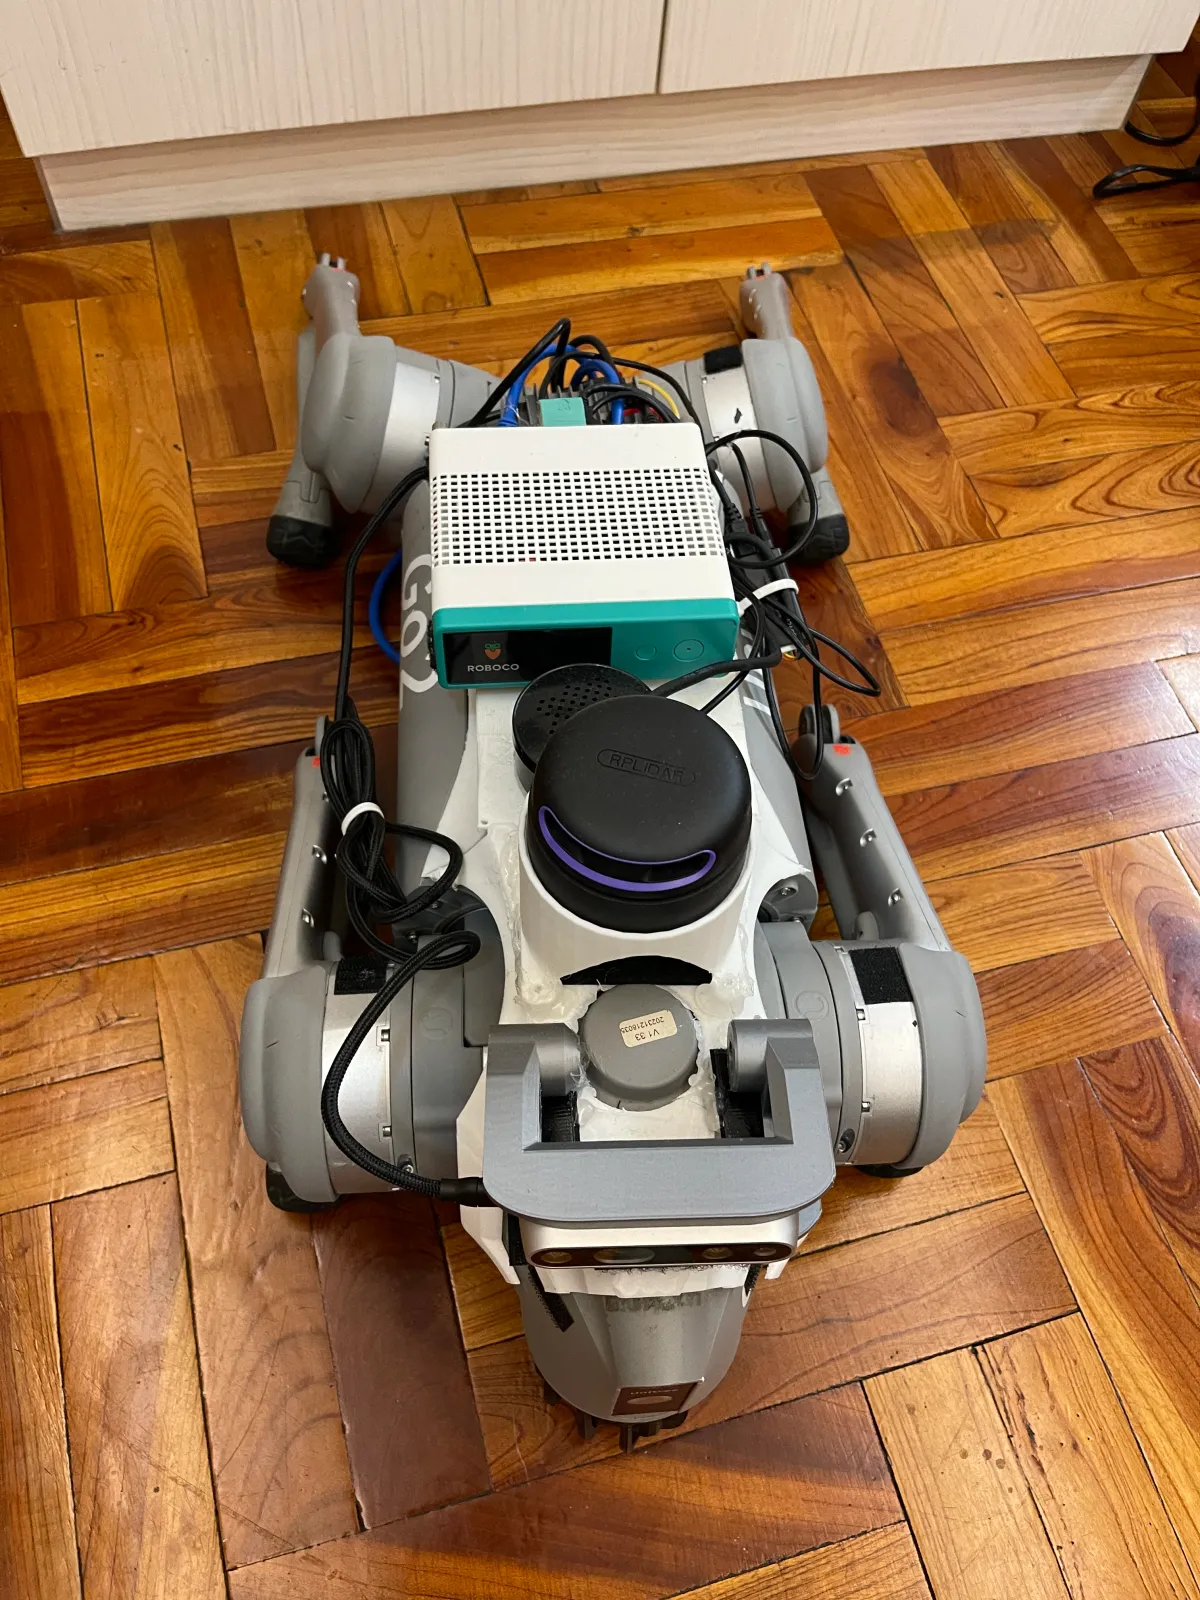
從上方看 PawAI 背上的配置。
供電:換了三顆降壓器
這是整個硬體裡最折騰的一段。Go2 電池的電壓大約 28.8 V,充飽時到 33.6 V;Jetson 需要的輸入是 9 到 20 V。所以中間一定要有一顆降壓器,把二十幾伏降到 19 V 左右。難的是在一隻會走路的狗身上,穩定地降壓。
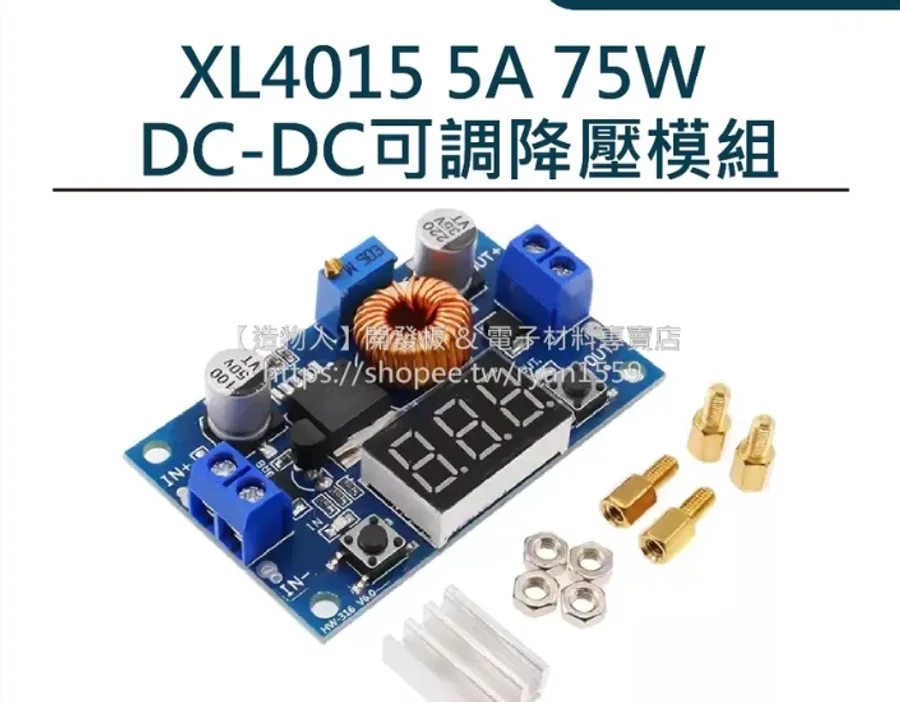
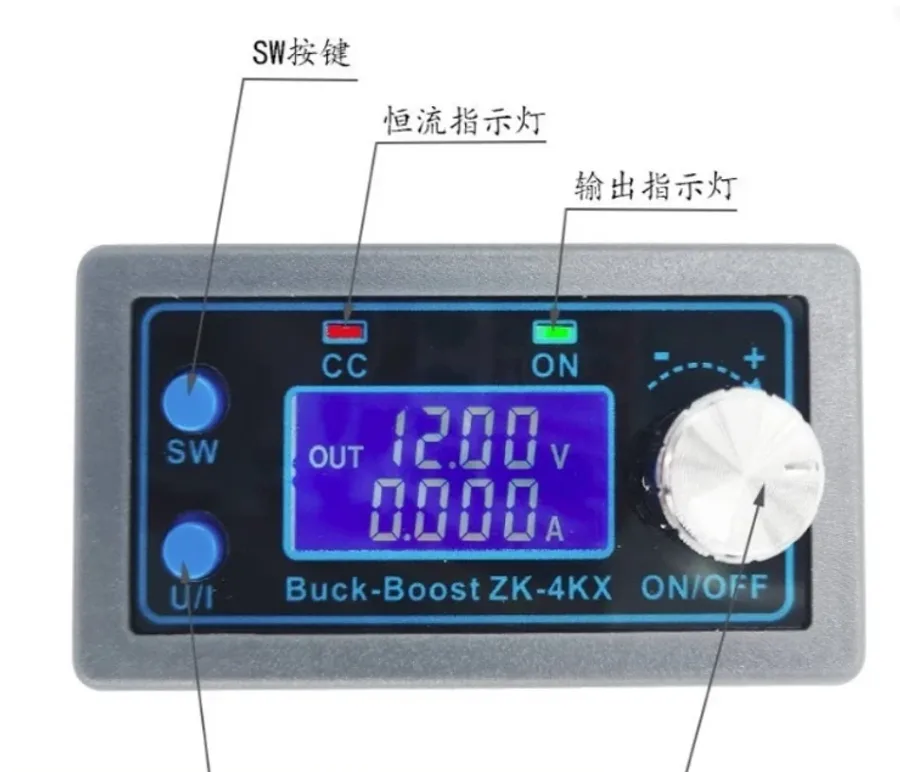
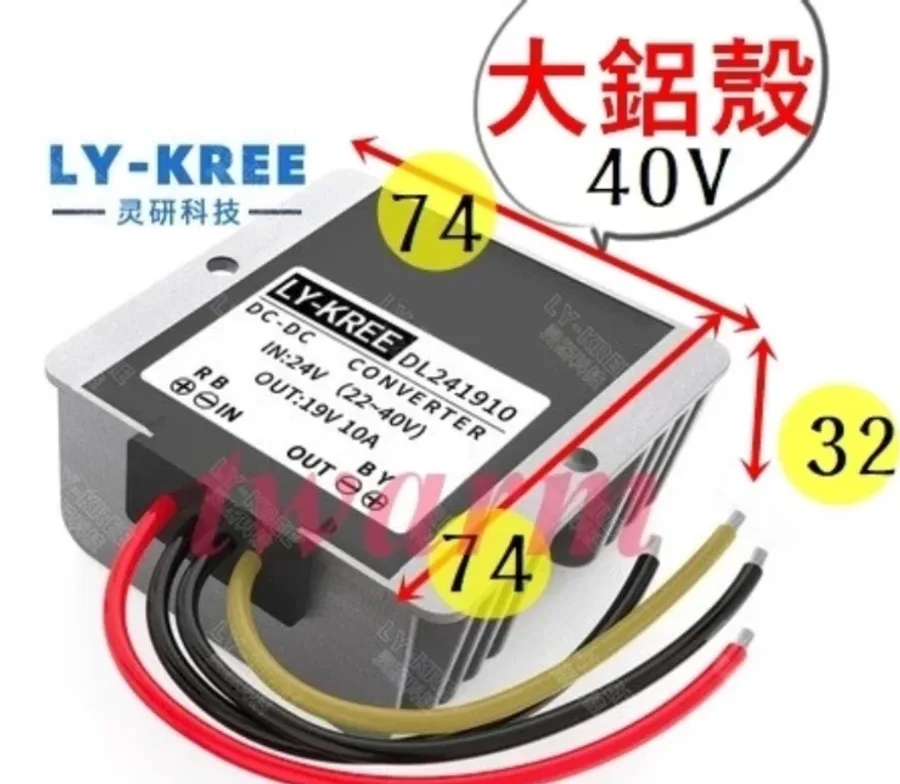
三顆降壓器的商品頁圖片(來源:蝦皮商品頁)。
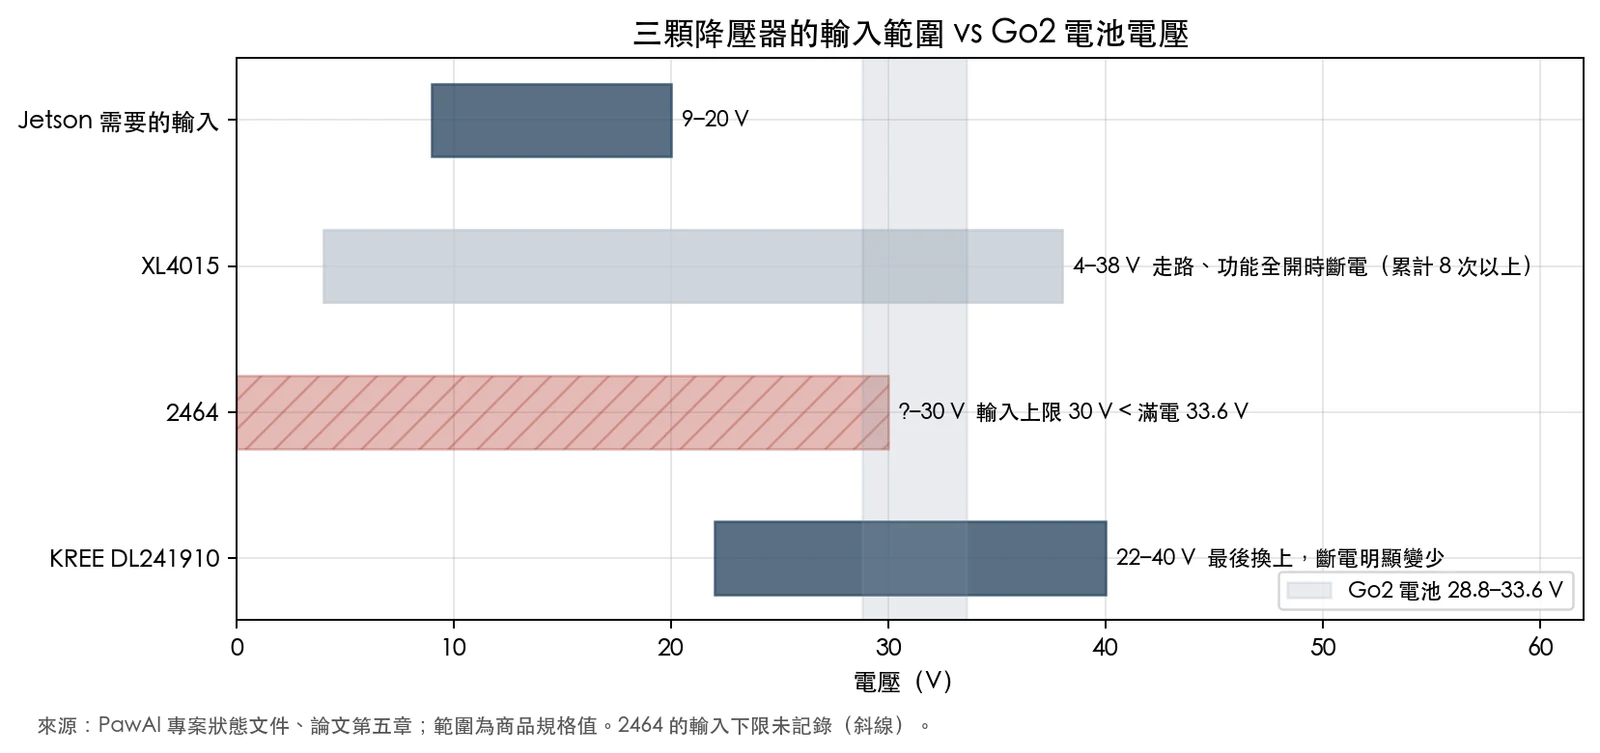
- XL4015:一開始用的是常見、便宜的模組,輸出調到 19 V。狗站著不動時沒事,一走路,或同時打開很多辨識功能,Jetson 就突然斷電重開,累計八次以上。平常大約吃 10 W,但瞬間電流會衝到約 3 A;我把輸出從 18.8 V 調到 19.2 V 改善了一陣子,還是撐不住,模組也會發熱。
- 2464:換上這顆可以數位設定電壓、有恆壓恆流保護的模組,當天晚上真的不再斷電了。但它的輸入上限只有 30 V,Go2 電池充飽時是 33.6 V。它不是「跟第一顆一樣的問題、更嚴重」,而是完全不同的失效原因。
- KREE:最後選的是鋁殼降壓器,輸入範圍 22 到 40 V,輸出固定 19 V、最大 10 A(190 W)。輸入範圍涵蓋 Go2 從低電量到充飽的整個區間,鋁殼本身就是散熱片。換上之後,斷電明顯變少。
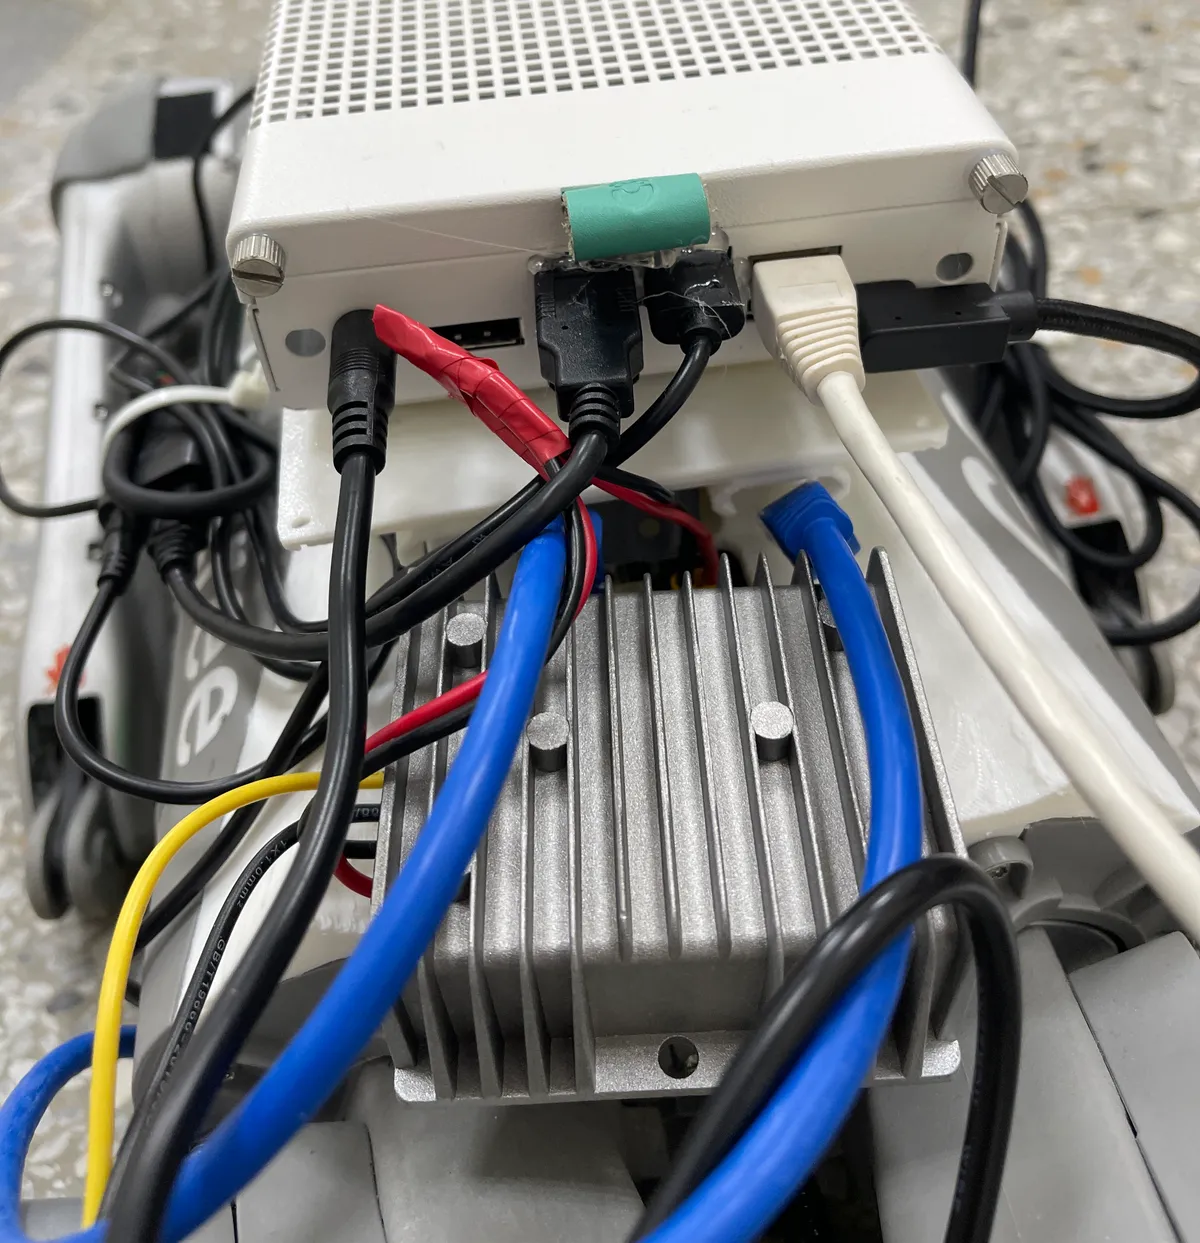
實拍:KREE 降壓器裝在 Go2 背上,上面是 Jetson 運算盒。
學到的事:挑降壓器不能只看「輸出幾伏」,要同時看三件事:輸入範圍有沒有涵蓋電池從沒電到充飽的整段電壓、瞬間電流會不會把電壓拉垮,以及小模組在狗背上會不會過熱。
算力:以為是記憶體,其實是 CPU
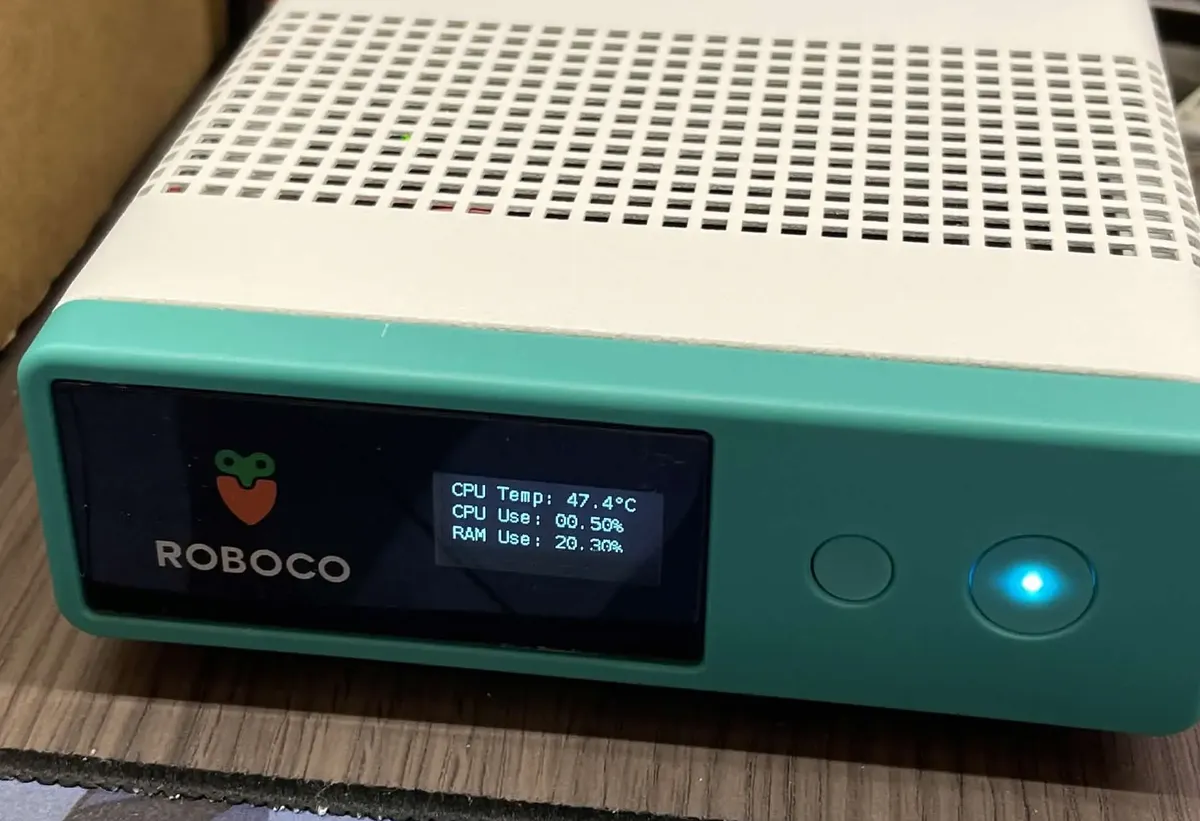
PawAI 的大腦:Jetson Orin Nano,前面的小螢幕即時顯示溫度和使用率。
Jetson Orin Nano 只有 8 GB 記憶體,而且 CPU 和 GPU 共用。上機之前,我先把每個候選模型單獨跑一輪,看速度和 GPU 用量,再決定誰該用 GPU:
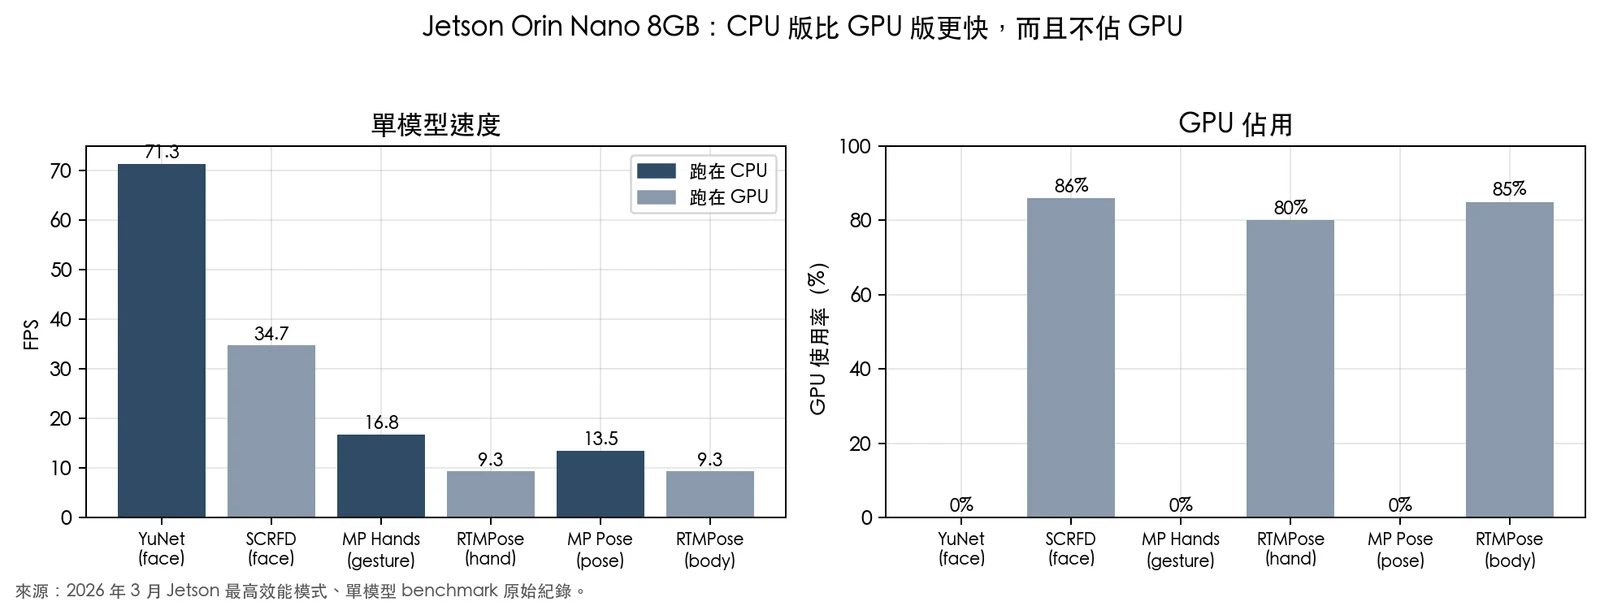
CPU 版的人臉模型比 GPU 版還快一倍,而且不佔 GPU;GPU 版的手勢和姿勢模型只有 9 FPS 左右,卻要吃掉八成以上的 GPU。所以最後只讓物體辨識(YOLO26n,TensorRT,約 15 FPS)用 GPU,人臉、手勢、姿勢都跑 CPU 版本。
當時我以為記憶體是最大的一道牆:論文裡估算,只開互動模組要 4.0 到 5.5 GB,加上導航要 5.5 到 6.7 GB,幾乎貼著上限。寫這篇的時候,我把狗重新開起來,用 tegrastats 各量了 60 秒:
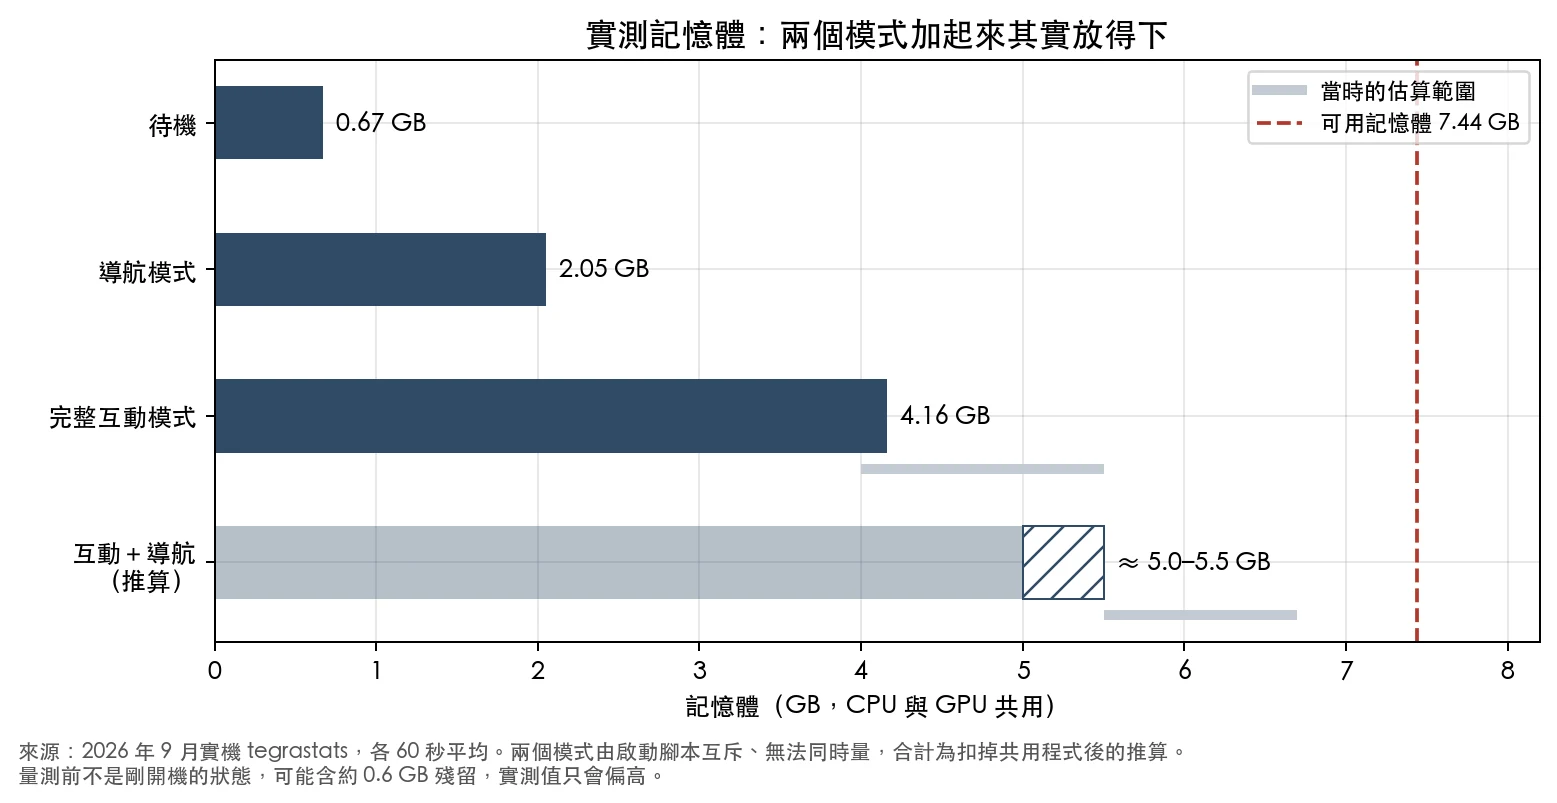
實測推翻了原本的結論。 完整互動模式(Go2 驅動、感知、語音、大腦、Studio 閘道全開)約 4.16 GB,導航模式約 2.05 GB。扣掉兩邊共用的驅動和相機,合計推算約 5.0 到 5.5 GB,還在 7.44 GB 的可用記憶體之內。
真正吃緊的是 CPU。下面是同一天、狗站著不動、沒有對話時的實測:
| 完整互動模式 | 導航模式 | |
|---|---|---|
| CPU 平均使用率 | 82% | 63% |
| Jetson 整板功耗(待機 4.6 W) | 10.2 W | 6.7 W |
| D435 彩色影像實際幀率 | 約 7 fps(設定 15) | 約 24 fps(預設設定) |
| 里程計訊息最長間隔 | 0.74 秒 | 0.12 秒 |
光開互動模式,CPU 就用掉八成,相機畫面只剩設定值的一半,里程計偶爾也會卡超過半秒。導航靠的就是穩定的里程計和雷達,我推測再疊上去,最先撐不住的會是 CPU,而不是記憶體。實際上兩套系統最後做成兩個互斥的啟動模式,專題發表時也分成兩段展示;它們從來沒有真的同時跑過,所以合計那一列只能是推算。
本地跑得動的小型語言模型和語音辨識也不夠好,所以語音辨識和 LLM 最後都搬到遠端 GPU。
還有一個小插曲:我曾經用一般的方式安裝物體辨識套件,結果它把 Jetson 專用的 PyTorch 和 NumPy 蓋掉,整個環境壞掉,救了半天。之後改成用 ONNX Runtime 加 TensorRT 跑模型,不再動系統內建的版本。溫度倒是比我擔心的好:連續運作 30 分鐘最高約 56°C。
機構:每一個零件都會鬆
- 喇叭:USB 喇叭一開始只是放在背上,狗一走路,震動就讓它接觸不良、斷線,最後用熱熔膠和束帶固定。
- 雷射雷達支架:雷達最早用魔鬼氈黏在狗背上,走路時會晃,掃出來的地圖越來越大、還出現疊影。後來重印一個支架固定,代價是雷達的位置和方向每改一次,軟體裡的座標設定就要重新校正。
- 深度相機的角度:要同時抬頭看人臉、低頭看腳前的障礙物。角度往上,低矮的障礙物要很近才抓得到;角度往下,又看不到站著的人的臉。
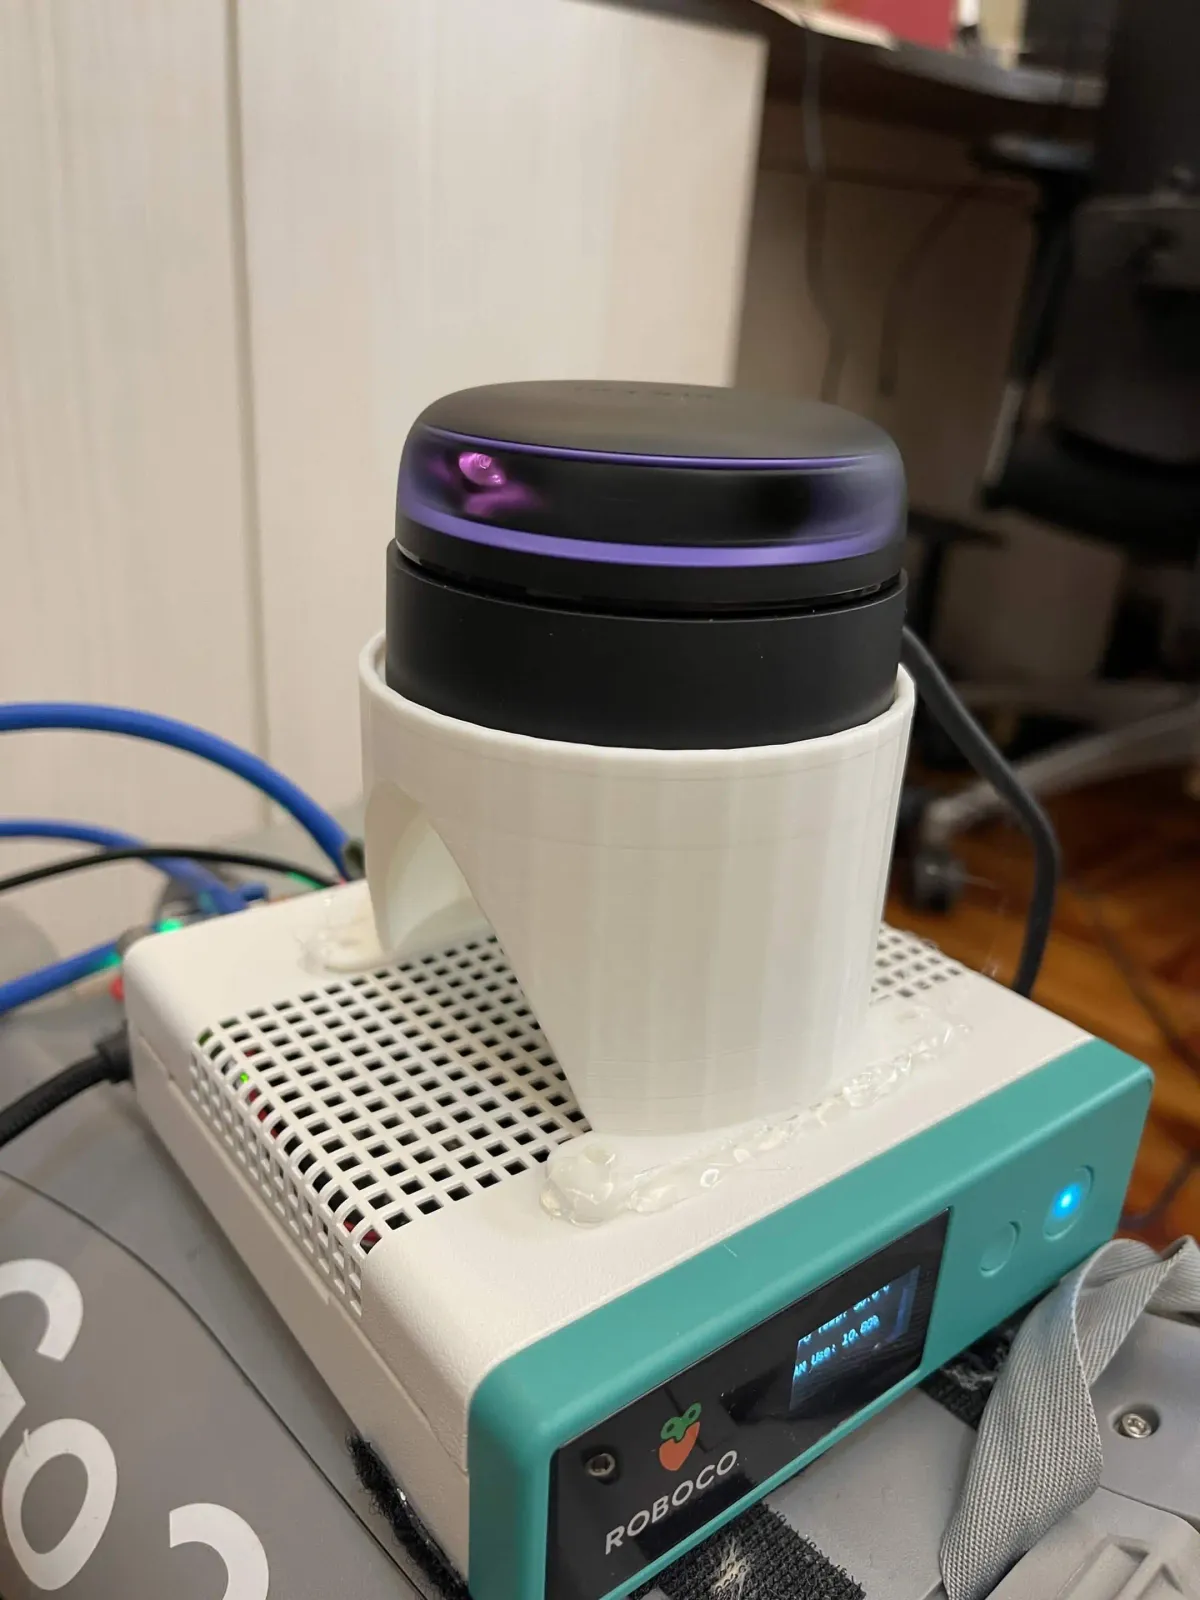
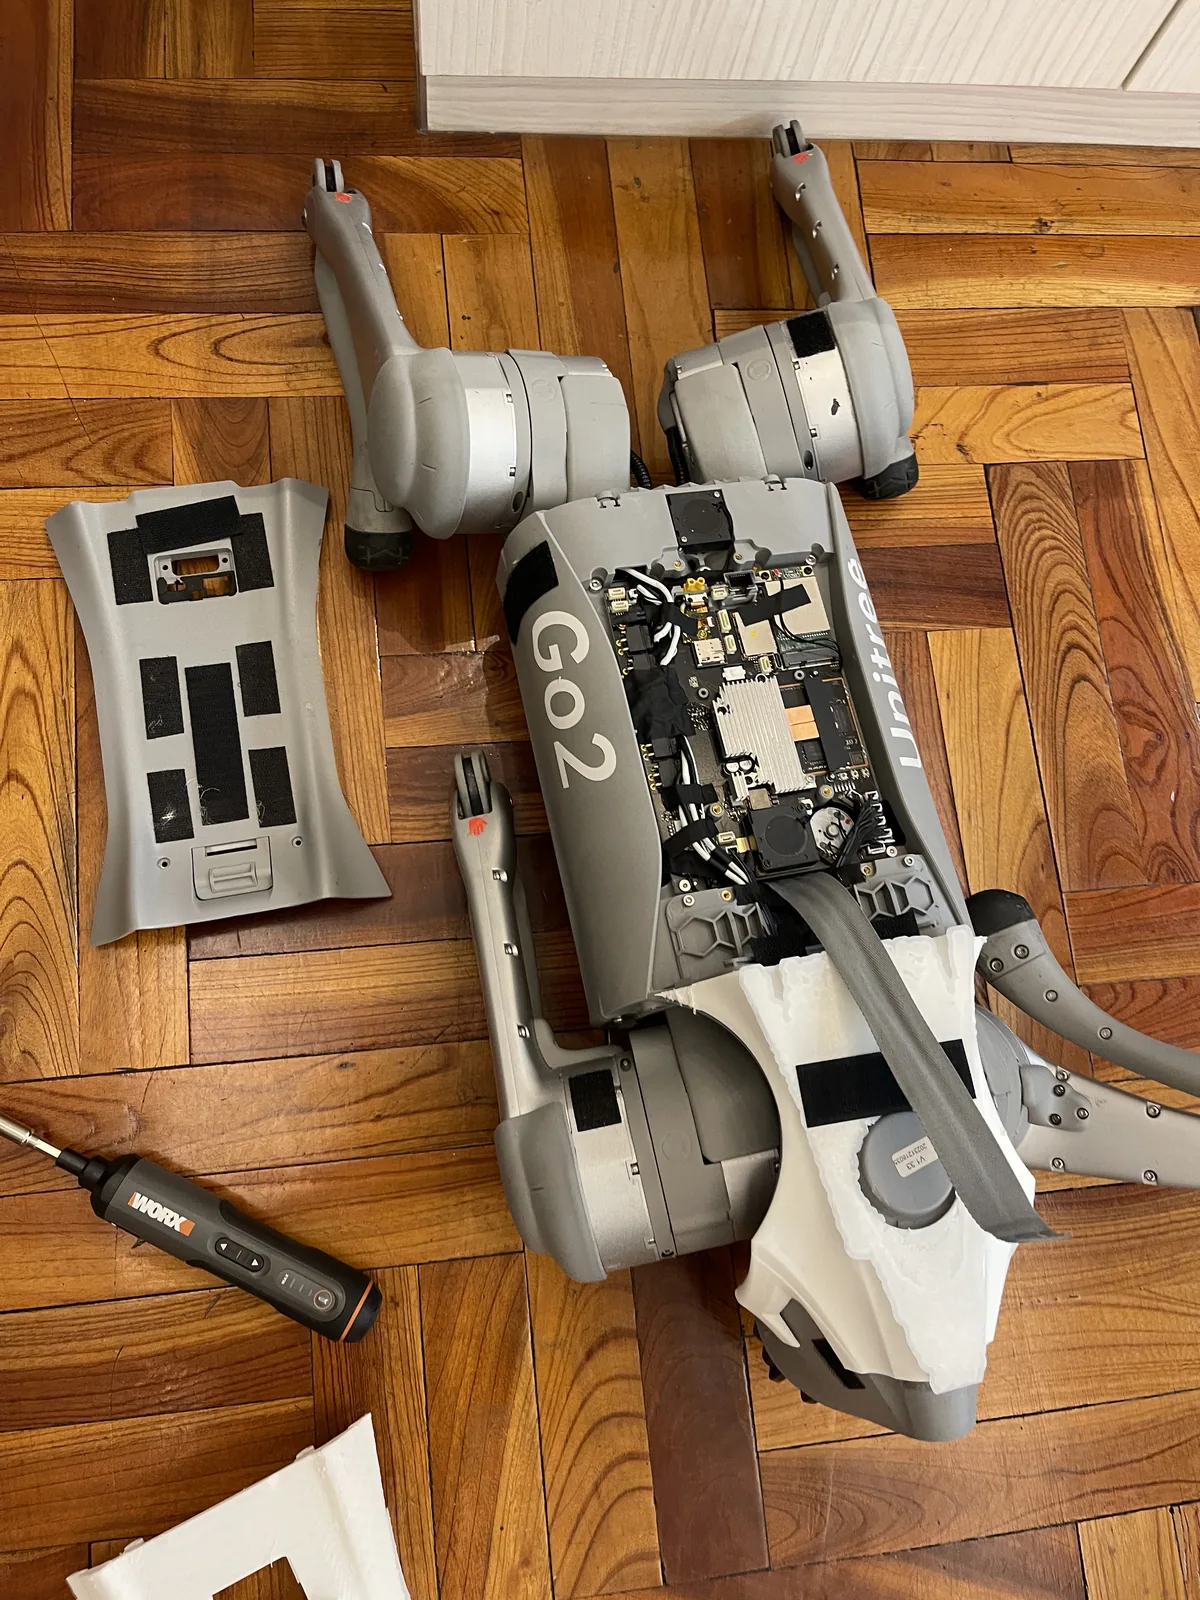
左:3D 列印的雷達支架,下面就是 Jetson 運算盒;右:四月時把運算、感測器和供電都裝上去的樣子。
網路:有線,而且不連外網
Jetson 和 Go2 之間最早走 Go2 內建的 Wi-Fi 熱點,延遲大約 700 毫秒:障礙物的資料送到時已經過時了,狗還因此輕撞過牆。後來改成網路線直接連線,延遲降到 1 毫秒以下。另外,Go2 連上網路時可能自動更新韌體,更新後控制介面的行為可能改變,所以展示當天一律不讓它連外網。
感測器:看得見,不等於真的看到
用 1 分鐘看懂三顆感測器各自看不到什麼。動畫裡的圖片是 AI 生成(Codex),數字來自實測紀錄。
做 PawAI 之前,我以為避障是軟體問題:感測器負責看,演算法負責判斷。做了八個月之後,我的想法變成:大部分的問題,在感測器「看得到什麼」那一層就決定了。
深度相機(Intel RealSense D435)
相機朝上看人臉,低矮的障礙物只會出現在畫面下緣。當時判斷「前方有沒有障礙物」的方式,是讀取畫面中央一塊區域的深度,所以低矮的東西要靠近到約 0.4 公尺內才抓得到;加上停車需要時間,早期三輪防撞測試全部撞上。
後來重測時,我把這個問題量得更清楚:在 0.5 公尺處放一個 20 公分高的箱子——
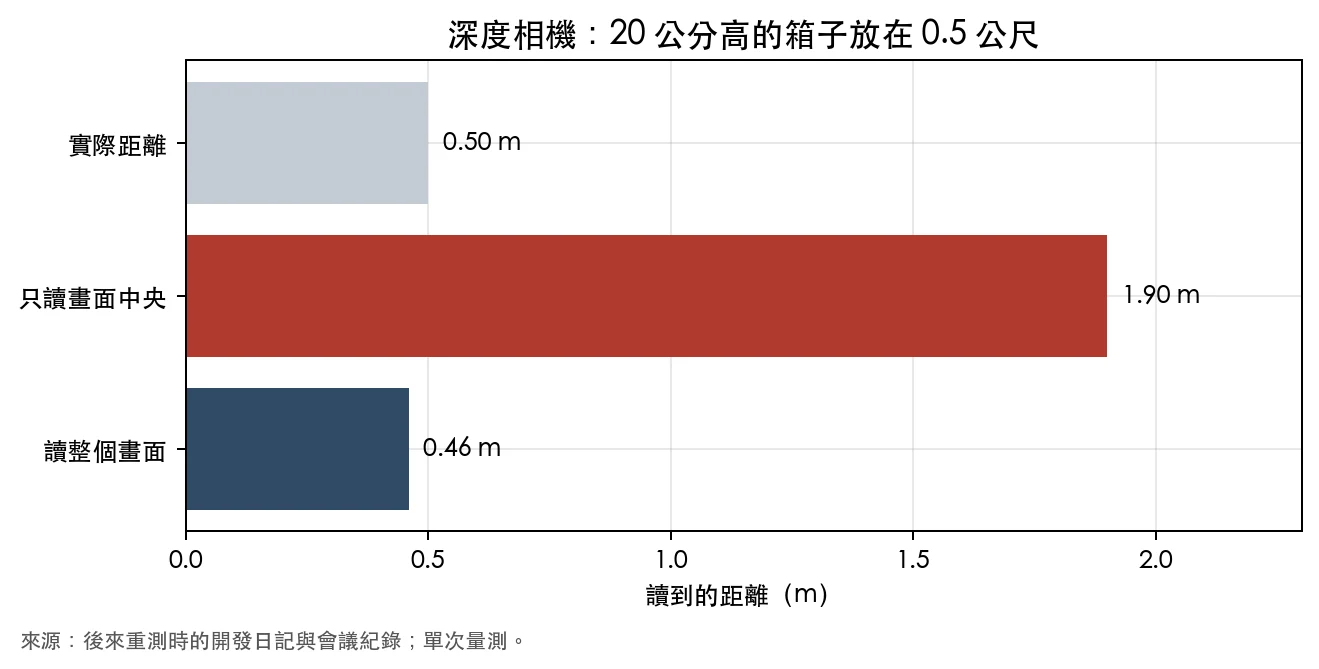
只讀中央,讀到的是後面的牆,等於沒看到箱子;改讀整個畫面、找最近的點,才量到 0.46 公尺。
還有一個架構上的問題:深度相機的判斷結果只會發出「前方是否淨空」的訊號,不會直接送出停止指令。有一次撞擊時,狗走的是另一條直接下動作指令的路徑,根本沒有經過這個判斷。感測器看到了,不代表那個資訊有接到控制狗的地方。
2D 雷射雷達(RPLIDAR A2)
2D 雷達只掃一個水平面。裝在狗身上,這個平面大約離地 0.5 公尺多,所以低箱子、細桌腳、低桌沿,還有黑色的物體,幾乎都掃不到。四足機器人走路時身體會前後、左右擺動,理論上也會讓掃描平面跟著傾斜;這點我只有推論,從來沒有在狗走路時同時記錄身體的傾斜角度和雷達資料,是之後一定要補的量測。
雷達裝在狗身上朝哪個方向(外參),前後改了好幾個版本。方向只要設錯,建出來的地圖就會轉向或反過來:
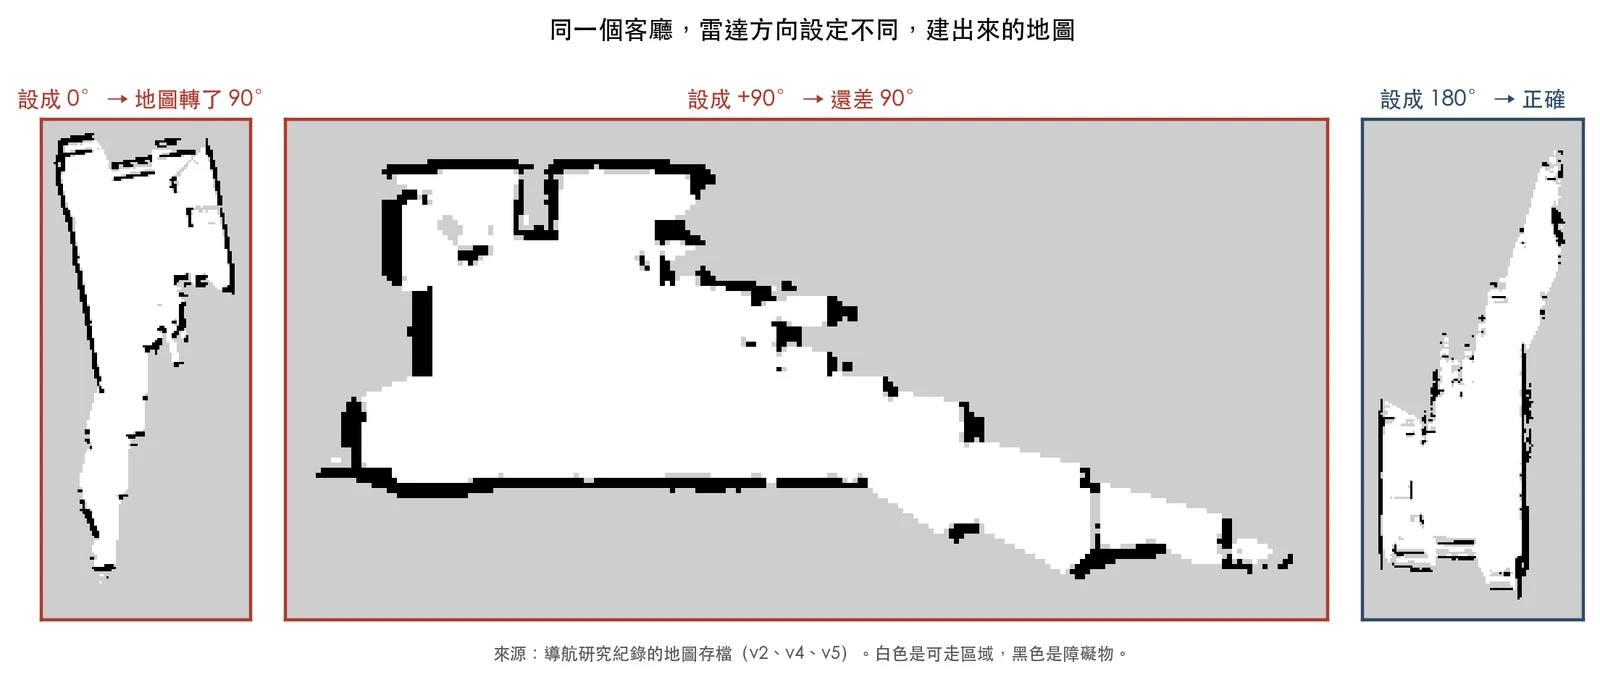
同一個客廳,用不同的雷達方向設定建出來的地圖。4 月底一天之內就試了四種方向,前幾張地圖全部作廢;之後又懷疑錯了 180 度而翻盤,最後對照實機才確定。
最可怕的是,方向錯的時候,地圖常常「看起來很合理」:
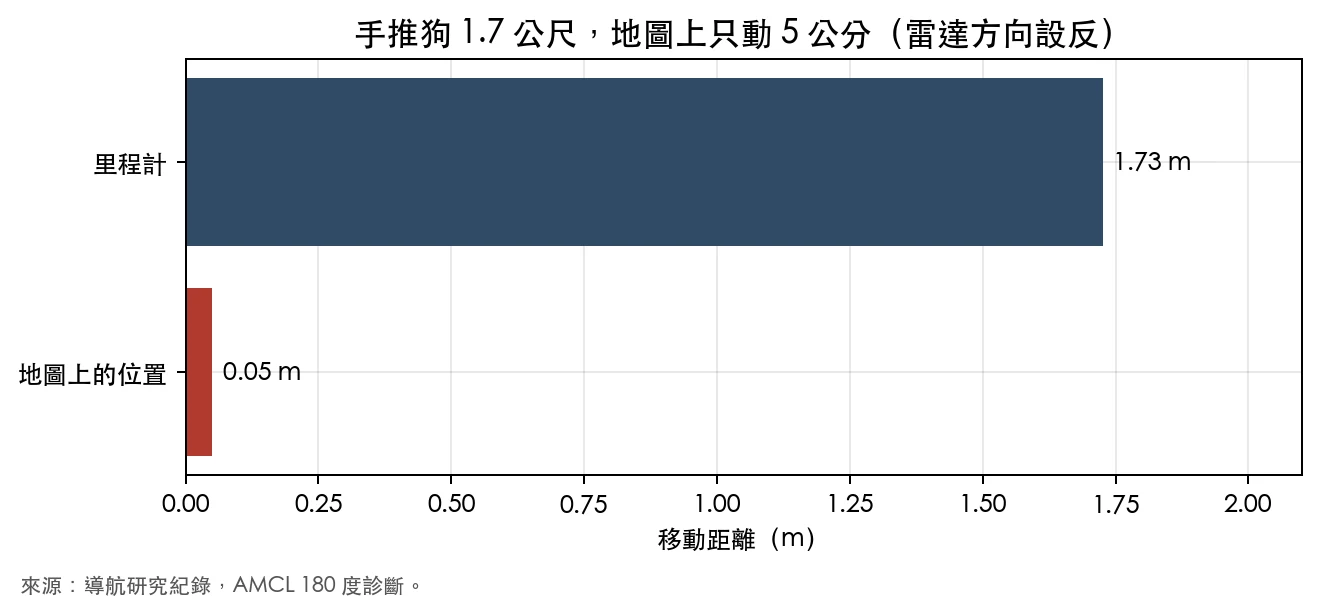
還有一次,雷達一直逾時,我以為是硬體壞了。同一天就翻案:啟動指令漏了一個參數,通訊速率的設定根本沒有套用。換成正確的指令後,外接的 A2 穩定在 10.57 到 12 Hz。
Go2 內建的 4D 雷達
Go2 頭部有一顆 4D 雷達,但 Go2 Pro 沒有開放完整的資料介面,只能透過 WebRTC 拿到一包壓縮過的資料。資料更新率一開始只有 0.03 Hz,而建地圖至少需要 5 Hz:
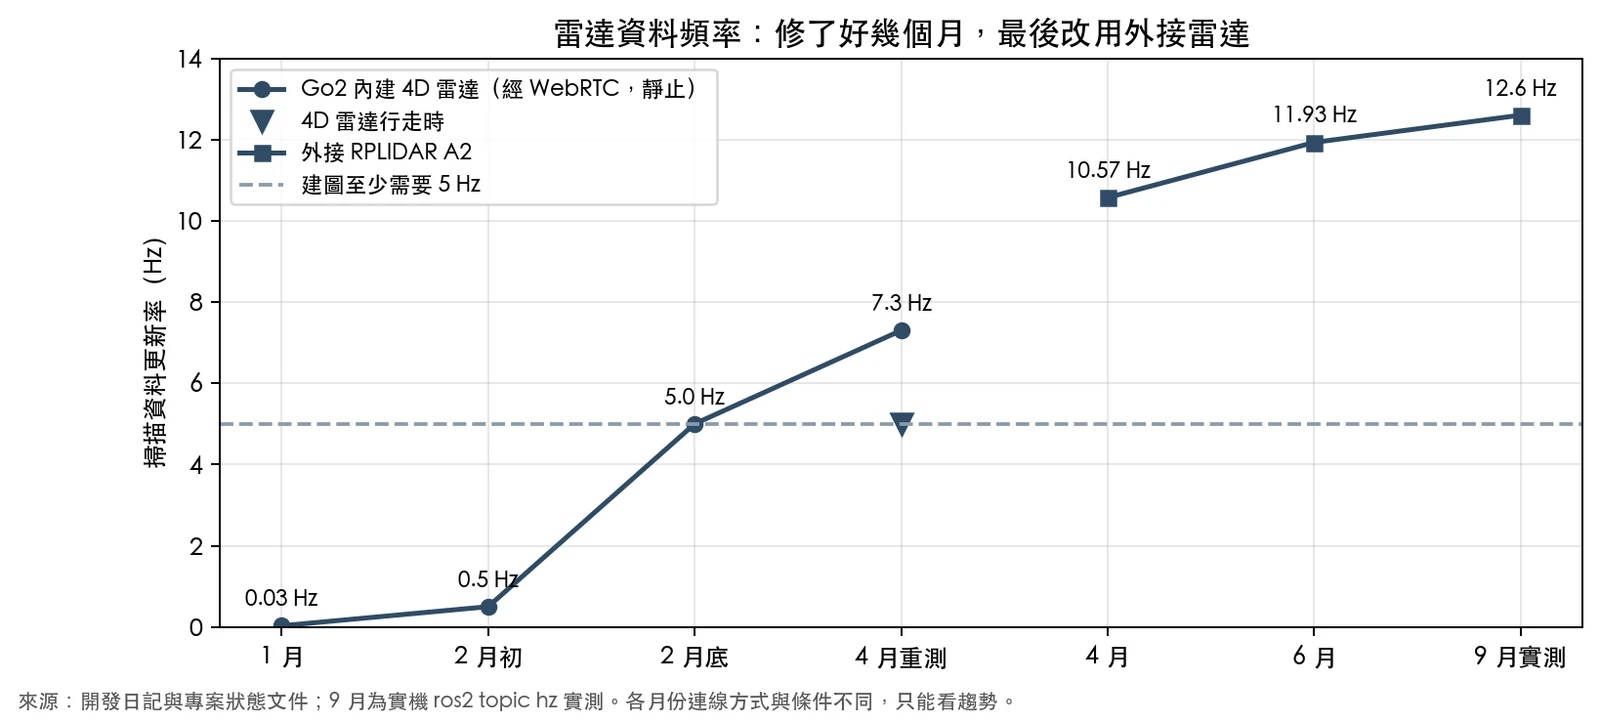
後來我把那包資料拆開,發現 77,824 bytes 乘以 8,剛好是 128 × 128 × 38 個格子:它不是一般的點雲,而是一個立體的「佔據格」,每一格大約 5 公分,代表那一小塊空間有沒有東西。把解碼改寫成一次處理整個位元陣列之後,解碼時間從幾百毫秒降到約 6.6 毫秒。
真正的問題出在重測:
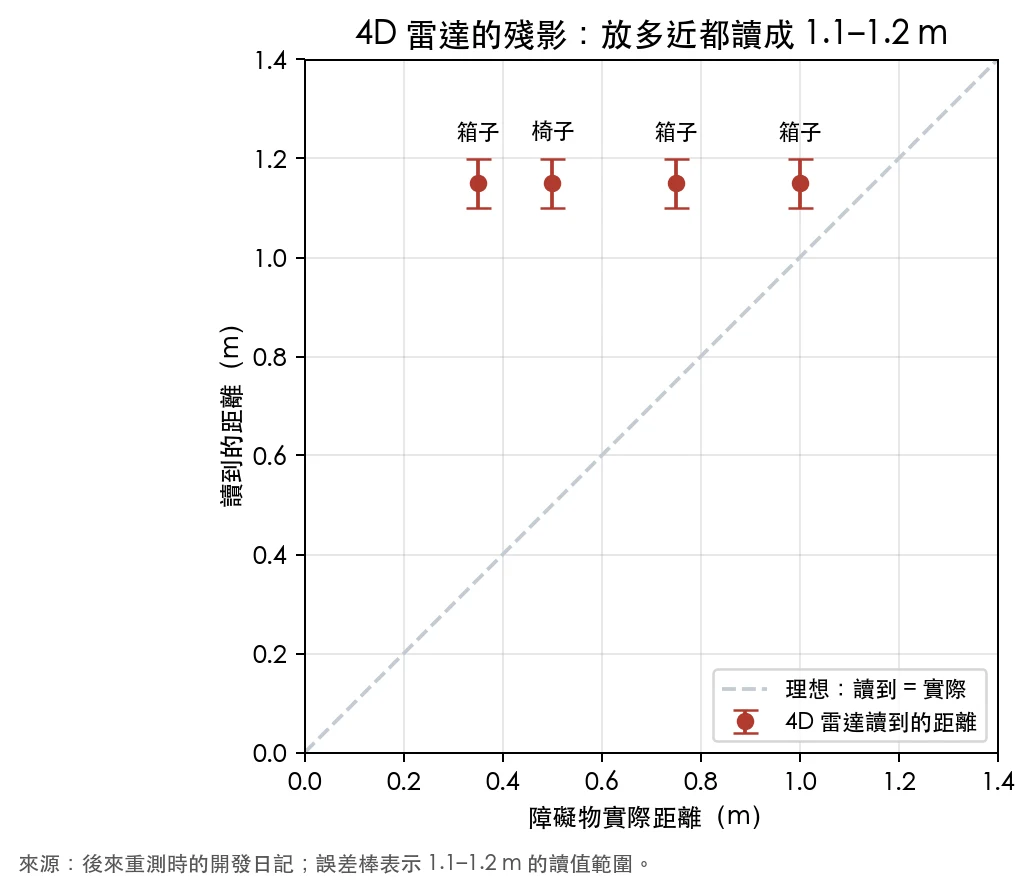
箱子不管放多近,讀到的距離都卡在 1.1 到 1.2 公尺;空房間裡,99.4% 的點都是舊資料。再驗證之後才發現,這個行為依高度而不同:離地 0.3 公尺以上的東西,放上去 1 到 3 秒會出現、移走 2 到 6 秒會清掉;離地 0.3 公尺以下的,只會累積、永遠不會清除;會移動的人則幾乎進不了地圖。所以 Unitree 的 App 看起來一切正常,我從程式拿到的資料卻有殘影,這兩件事可以同時成立。
我也懷疑過是不是 IMU 或里程計的更新出了問題:這個格子的座標原點跟著里程計走,里程計漂移可能讓舊的格子看起來像殘影,但我沒有找到 IMU 參與其中的直接證據,這仍然是推論。最後的判斷是:4D 雷達可以當作高處障礙物的補充,但不能取代 2D 雷達。
三顆感測器的共同教訓
- 盲區:每顆感測器都有看不到的高度和距離,而低矮的東西剛好落在所有感測器的盲區交集。
- 座標:感測器裝在哪裡、朝哪個方向,只要錯一點,所有下游的判斷都會錯,而且錯得「很合理」。
- 接線:看到了,不代表有接到控制狗的那條路徑上。
之後會改的方向:每顆感測器都要有固定的量測流程(固定距離、固定大小的物體);外參校正要變成正式步驟,而不是看「地圖對不對」;深度相機負責近處和低矮物、2D 雷達負責建圖和中距離、4D 雷達補高處,而避障判斷要同時看三者,並直接接到會送出停止指令的地方。長期來看,多線 3D 雷達會更適合四足機器人。
導航:大多數撞擊,不是因為看不到
回頭整理導航的每一次失敗,我最意外的是:大部分撞擊的原因不是「演算法沒看到障礙物」,而是「時間」和「控制權」出了問題。
停不下來的物理限制
就算看到了障礙物,狗也不是說停就停:
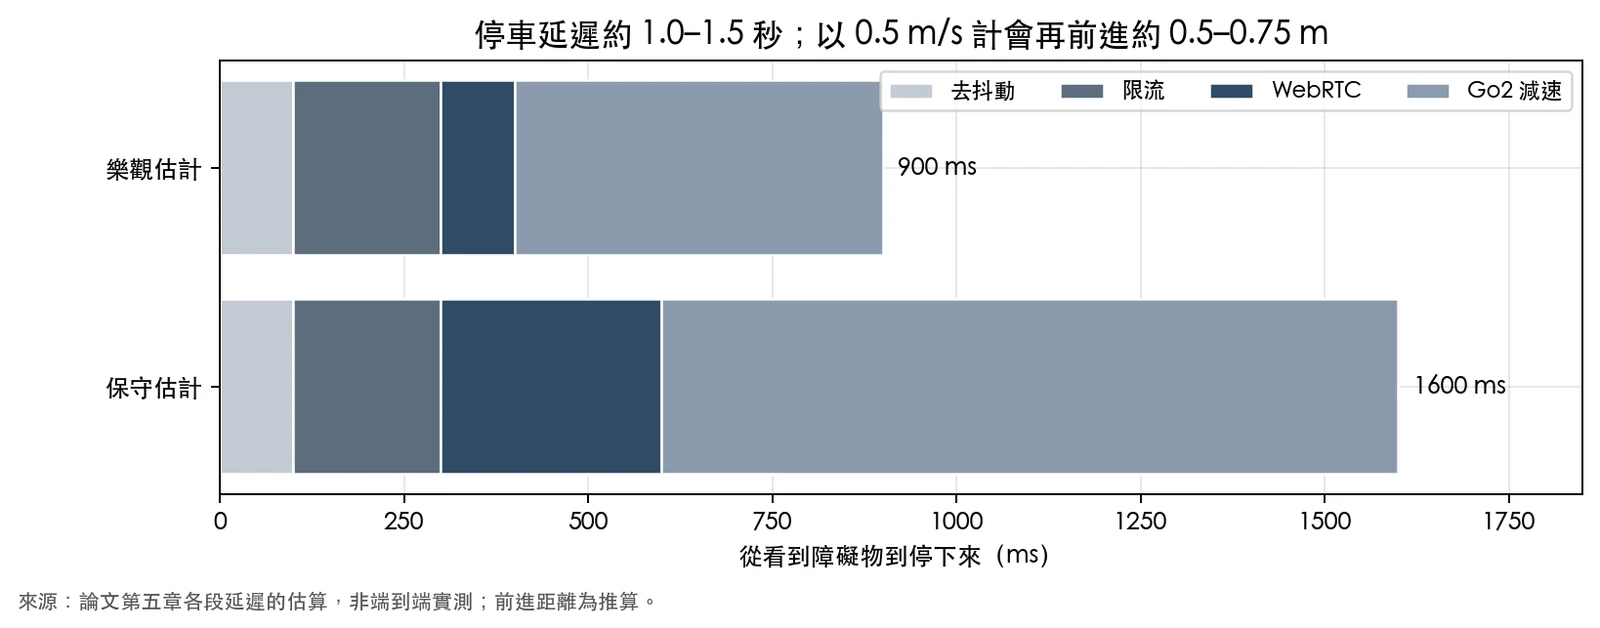
Go2 的移動指令最低大約 0.5 m/s;從看到障礙物到真的停下來,要一秒以上。在最窄 0.9 公尺的走道裡,這個餘裕幾乎不存在。後來撞牆一次,才把「危險距離」從 0.6 公尺拉到 1.1 公尺。
控制權:誰在開這隻狗
- 停障節點在看後面:負責「前方有障礙就停」的程式,看的其實是狗的背後,所以 30 公分外的紙箱照撞。
- 舊的指令又接管了控制:停障程式判斷「淨空」後就停止發送指令,大約半秒後,舊的前進指令重新接管,狗就往前衝。
- 沒有新指令,Go2 就沿用最後一筆:單獨測試時狗會在障礙物前 30 公分停下;接回完整系統卻撞上。原因是中間負責切換指令的程式,只有在收到輸入時才會輸出,輸入一停,Go2 就一直執行最後那筆「往前走」。
- 救援時用錯指令,狗摔倒:繞行時狗甩動得太厲害,我想讓它停下來,卻送出了讓馬達卸力的指令,Go2 直接摔倒。
- 檢查全綠,第一步就撞:就是開頭那一幕。靜態檢查只驗了位置誤差,沒驗朝向;初始朝向不準,第一步就走歪。
這些問題的共同點是:每一個模組單獨測都是對的,接在一起才出錯;而且錯誤訊息看起來都很合理,要花很多時間才找到真正的原因。
語音與互動:機器狗很吵,事件會打架
麥克風被風扇蓋過
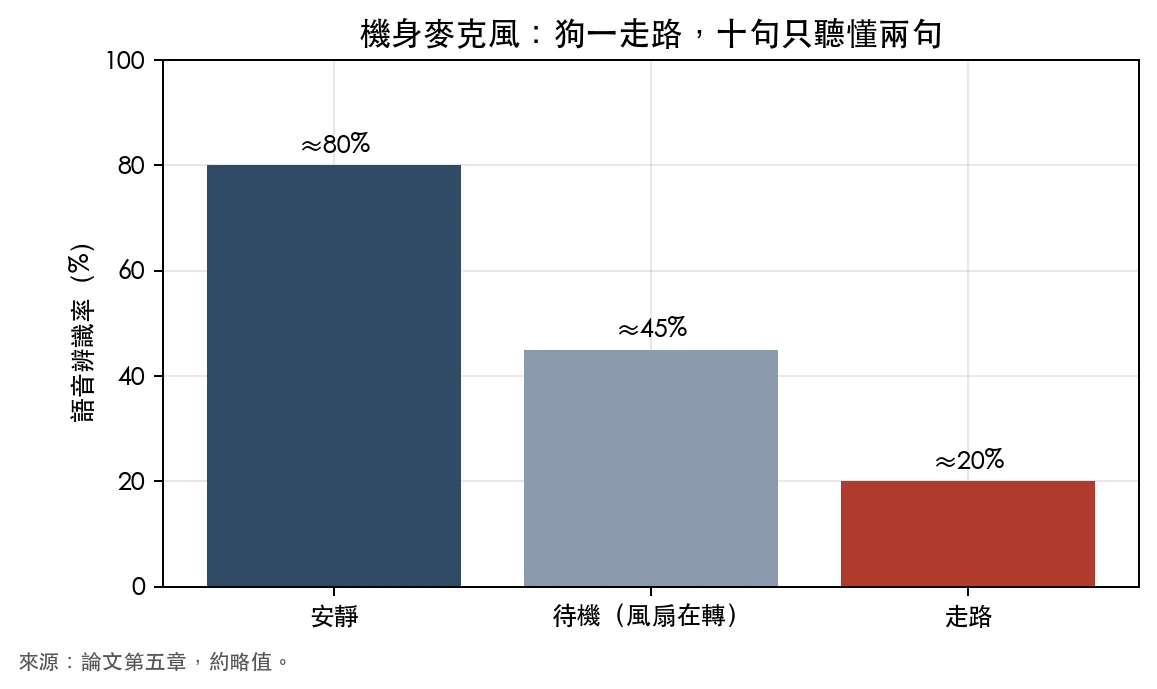
機身麥克風收到的聲音被 Jetson 的風扇和走路的噪音蓋住,狗一走起來,十句只聽得懂兩句。調高麥克風增益也沒用,反而更差。最後改成用筆電收音,「停止」這種一定要成功的指令,也改成用手勢。
換模型:Whisper 只有 52%
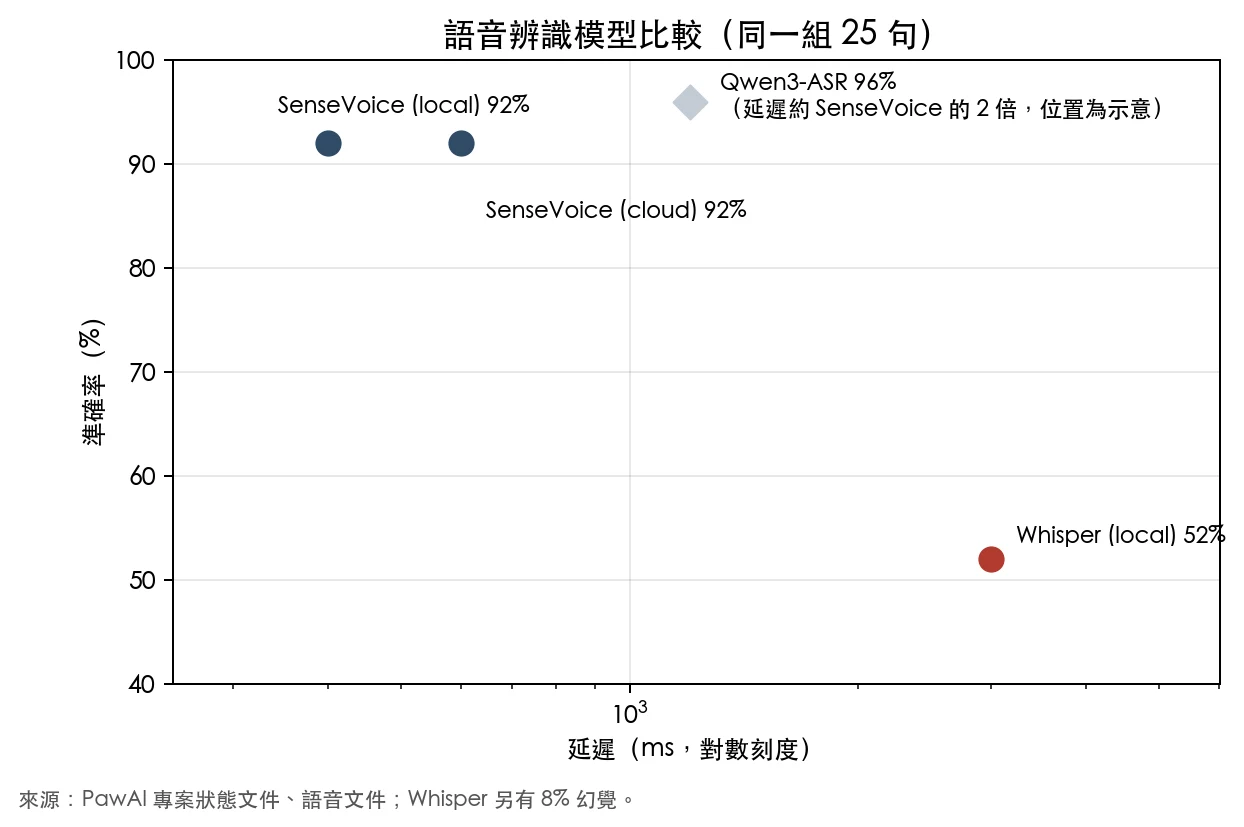
一開始用的 Whisper 在同一組 25 句裡只對了 52%,還會憑空生出字幕。換成 SenseVoice 之後到 92%,延遲只要幾百毫秒。
說完一句話,要等多久
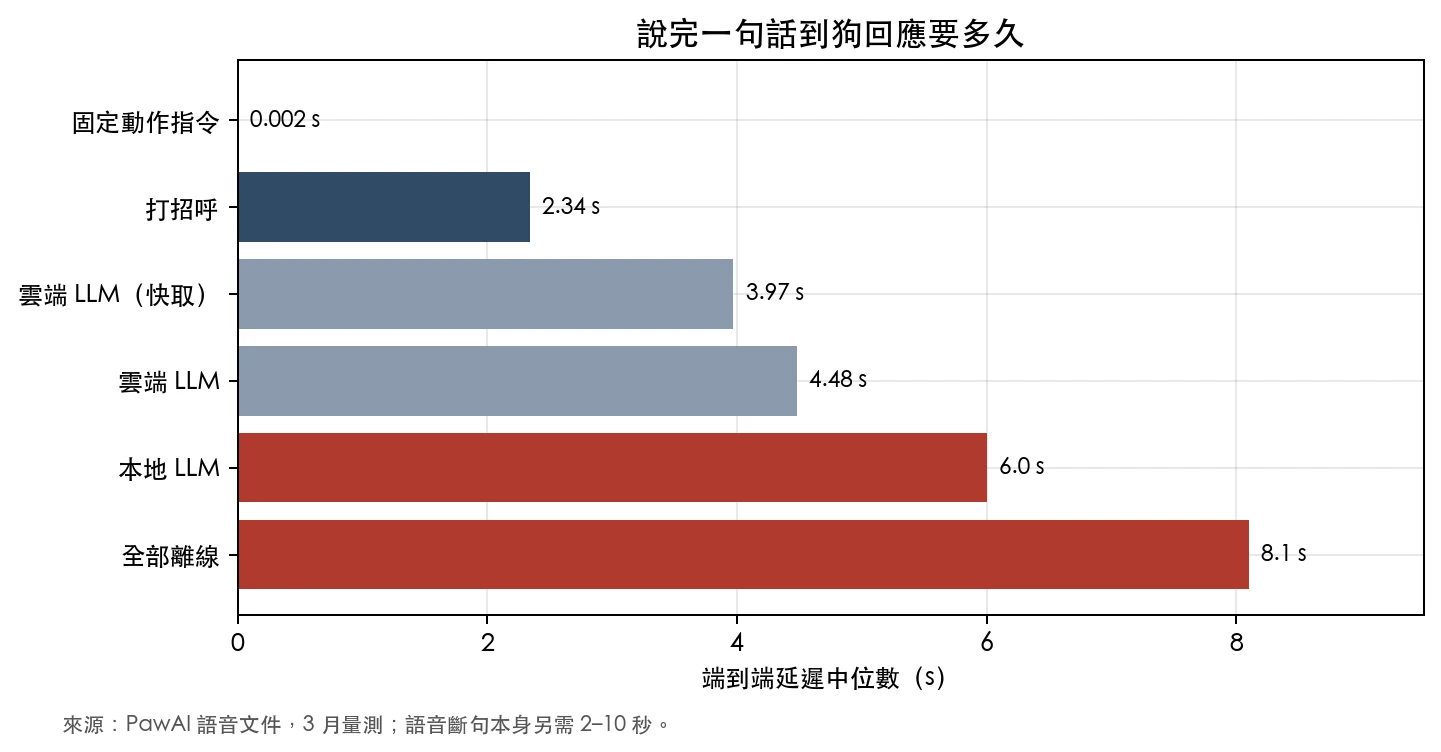
最大的瓶頸其實不是模型,而是「判斷你講完了沒」:語音斷句本身就要 2 到 10 秒。經過幾輪優化,端到端延遲從 3 月的 5.7 到 14.5 秒,降到 5 月的大約 5 到 8 秒。
讓狗說話:Gemini TTS 加兩層備援
狗要回話,用的是 Gemini Flash TTS,聲音選的是 Despina(這個網站動畫的旁白,也是同一個聲音)。因為它走雲端,我替它準備了兩層備援:Gemini 失敗就換 edge-tts,再不行就用完全離線的 Piper。
我故意填錯 API key 實測過:Gemini 失敗後,edge-tts 會自動接手把話講完;不過 edge-tts 接得住,所以最後一層 Piper 那次沒有被用到,還沒在實機上驗證。
Gemini TTS 也有自己的坑:
- 每段前後都有空白:每段音訊前後大約有 80 到 200 毫秒的靜音,我另外寫了一個模組把它修掉。
- 長句會「跳句」:長一點的回覆會切成好幾段同時合成,回來的同一個聲音,音量卻一段比一段大(實測的音量數值從 782、1139 跳到 1529),聽起來就像越念越大聲、又突然變小。
其他坑
- 講長一點的故事一定斷在 30 字:我查了 5 個小時,最後發現 Jetson 上跑的根本是舊版程式,新的修正沒有部署上去。
- 狗的喇叭要逆向工程:Go2 內建喇叭只支援特定格式,還有沒寫在文件裡的限制,花了大約兩週才讓它穩定出聲,修好後連續 20 次都成功。
- 事件互搶,狗不說話:同一時間看到人臉、看到杯子、看到手勢,事件會互相搶著說話,結果誰都沒說出來。
- LLM 會編造看到的東西:例如說外面在下雨、說看到了杯子,實際上都沒有。
測試很多,不等於可靠
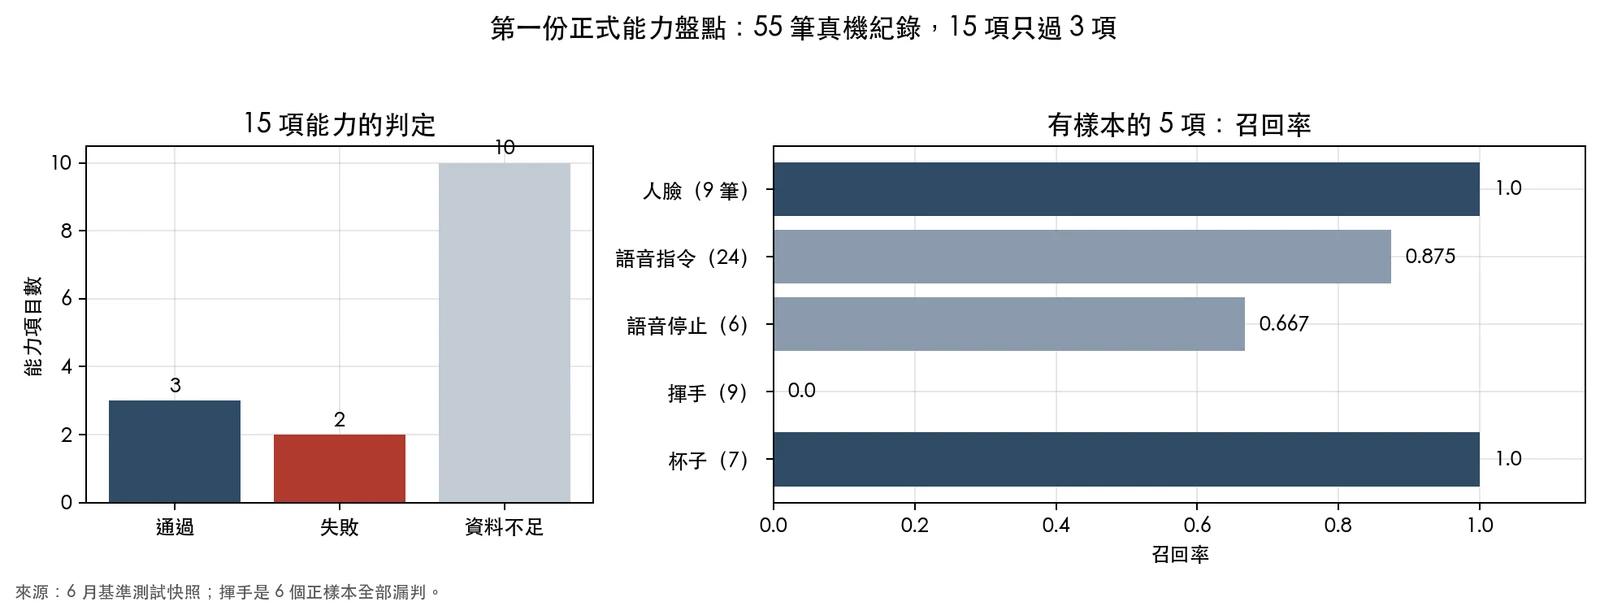
6 月,我做了第一份正式的能力盤點:用 55 筆真機原始紀錄,替 15 項能力打分數。結果 3 項通過、2 項失敗、10 項連足夠的樣本都沒有。揮手辨識的 6 個正樣本全部失敗,「停止」6 次漏了 2 次。那次之後我才真正接受,「功能都寫好了」和「量過、確定能用」是兩件事。
有幾種「假通過」一再出現:
- 測試腳本沒有在失敗時停下來,顯示全部通過,其實有幾項根本被跳過。
- 設定檔的換行格式不對,展示流程顯示成功,實際上服務沒有啟動。
- 好幾次真機跑的都不是最新的程式:改了參數沒重新編譯、安裝目錄沒更新、修正沒有部署到 Jetson。每一次我都以為在測新版本。
- 有一天合併了 8 個 PR、累積約 955 個測試,同一天導航仍被判定不能對外展示。

AI 生成的示意圖(Codex):同一個情境應該逐層升格,從單元測試、重播、模擬、原地不動的整合測試,最後才是限速、短距離的真機測試。
AI 寫得更多,為什麼狗沒有變得更可靠?
這八個月我一直和 AI coding agent 一起開發。它讓規格、程式、測試和審查報告以驚人的速度長出來,但狗並沒有因此變得更可靠。回頭看,原因大概有三個:
第一,真機驗證沒有變快。 AI 可以一天寫出上千行程式、幾十個測試,但能上機的狗只有一隻,電池、場地和操作者也只有一組。程式產得越快,等著上機驗證的東西就堆得越高。
第二,三種時間尺度被塞進同一張驗收單。 我同時想要「近期讓狗可靠移動」「中期做成完整產品」「長期研究一套可擴充的架構」,卻把它們放進同一個月、同一場展示、同一份驗收標準。結果每一項都做了一點,沒有一項收斂。
第三,AI 的第一個解釋常常是錯的,但聽起來很完整。 撞牆那次,一開始的分析把原因歸到導航的視距;我親自對照紀錄,才發現那時在控制狗的根本不是導航。「雷達硬體壞了」這個判斷,後來也被推翻,其實只是啟動指令少了一個參數。AI 很擅長把現有證據編成一個合理的故事,但只有真機和原始資料能告訴你故事對不對。
另一個教訓是安全設計。為了避免危險,我在系統裡加了一層又一層的安全檢查;結果所有整合上的不確定,最後都變成「安全檢查不讓它動」。系統越來越會解釋為什麼不能動,卻一直沒能在安全的情況下真的動起來。
真正的問題:能力很多,卻沒有一個場景

AI 生成的示意圖(Codex):什麼都會一點,卻不知道要用在哪裡。
把上面所有困難攤開來看,我覺得最根本的問題不在某一顆感測器、某一段程式,而是:我們在一隻狗身上整合了很多多模態能力,卻沒有一個具體的使用場景,也沒有一個真正能拿來用的功能。
證據其實一直都在:
- 驗收時被問定位:評審問「這是狗、機器人,還是助理?」也有人質疑:「把機器狗拿掉,用手機是不是也做得到?」
- 只有分散的功能,沒有完整的產品感:人臉、語音、手勢、姿勢、物體辨識各自能動,但使用者要拿它來「做什麼」,說不清楚。
- 測不出來,是因為不知道要測什麼:15 項能力裡 10 項資料不足。不是不想測,而是沒有場景,就不知道「成功」長什麼樣子、要在什麼環境下測、測到什麼程度才算夠。
- 展示只能分段、靠備案:移動和互動不能一鏡到底,重要段落都要準備預錄影片,還整理了一張「可以講/不能講」的清單。
- 模型能產生事件,不等於事件符合使用者的需要:系統看得到杯子、看得到揮手,但使用者真正需要它在什麼時候、做出什麼反應,一直沒有被定義。
評審還點出一件事:我在台上一直講「做不到的東西」,真正困難、也最有價值的過程,像是硬體改裝、SDK、換了三顆降壓器,反而完全沒提。這篇文章某種程度上就是在補這一段。
如果重來一次,我會把順序倒過來:
- 先定一個具體的場景:誰會用、在哪裡用、要解決什麼問題。
- 從場景反推需要哪些能力:不是先把所有感測器和模型都裝上去,再找用途。
- 替每個能力定義「成功」:在什麼環境、什麼距離、成功率多少才算數。
- 在真實的場地、用真實的流程去測:客廳裡的 0.3 公尺,和使用者真正會遇到的情況,是兩回事。
硬體上也會先把電源和算力當成正式的設計:先查清楚電池的電壓範圍和尖峰電流、先實測記憶體和 CPU 能同時撐多少,再決定要加哪些功能;感測器的支架也一次做對,不要每改一次位置就重新校正、重新測。
多模態整合本身不是目標,它要為某個場景服務,才有辦法被測試、被改進、被真正用起來。 這是 PawAI 八個月教我最重要的一件事。
參考資料
PawAI 的原始碼、硬體狀態紀錄、感測器測試紀錄與狀態文件。